Insight
Synthetische Daten für KI-Training: schneller, günstiger, riskanter.
Synthetische Daten beschleunigen die Modellentwicklung, erben aber die Verzerrungen ihrer Vorlage. Wie Institute Kreditmodelle trotzdem verantwortbar prüfen.
KI & Digitalisierung
6 min Lesezeit
Kernaussage
Synthetische Daten erben die Verzerrungen ihrer Quelle und verstecken sie besser. Wer sie im Kredit- und Risikogeschäft einsetzt, prüft das Modell so streng, als stünden echte Kundendaten dahinter.

Die wichtigsten Erkenntnisse
Synthetische Daten beschleunigen Modellentwicklung
Sie tragen Verzerrungen weiter oder verstärken sie
Kreditmodelle sind davon besonders betroffen
Die Abkürzung mit Nebenwirkungen
Synthetische Daten sind künstlich erzeugte Datensätze, die echte Trainingsdaten ersetzen oder ergänzen. Sie versprechen einen erheblichen Vorteil: Modelle lassen sich schneller und günstiger entwickeln, ohne dass echte, oft schwer zu beschaffende und datenschutzrechtlich heikle Kundendaten in großer Menge nötig sind. Synthetische Daten erben aber die Verzerrungen ihrer Quelle und verstecken sie besser; im Kredit- und Risikogeschäft gehört ein Modell, das auf ihnen trainiert wurde, deshalb so streng geprüft, als stünden echte Kundendaten dahinter.
Finanzinstitute experimentieren zunehmend mit synthetischen Daten, um ihre Modellentwicklung zu beschleunigen. Darauf wies Ian Holmes, Global Lead für Enterprise Fraud Solutions beim Softwareanbieter SAS, im Januar 2026 im Jahresausblick des IT-Finanzmagazins hin, verbunden mit einer Warnung: Subtile Verzerrungen können so in Kredit-, Betrugs- und Risikoprozesse gelangen.
Wie Verzerrungen in synthetische Daten gelangen
Verzerrungen gelangen über die Vorlage in synthetische Daten. Eine Verzerrung in Trainingsdaten entsteht, wenn bestimmte Gruppen über- oder unterrepräsentiert sind oder wenn historische Daten Muster enthalten, die nicht den gewünschten Maßstäben entsprechen. Ein Generator, der aus solchen Daten synthetische Daten erzeugt, lernt die vorhandenen Muster und reproduziert sie. Die synthetischen Daten sehen anders aus als die echten, folgen aber denselben statistischen Mustern, einschließlich der verzerrten.
Tückisch ist, dass die Verzerrung im synthetischen Datensatz schwerer zu erkennen ist. Bei echten Daten lassen sich Herkunft und Zusammensetzung nachvollziehen. Bei synthetischen Daten ist der Zusammenhang zu den ursprünglichen Verzerrungen verschleiert, und es entsteht der trügerische Eindruck, mit einem neutralen Datensatz zu arbeiten. Dieser Eindruck senkt die Aufmerksamkeit für die fortbestehenden Verzerrungen.
Können synthetische Daten Verzerrungen sogar verstärken?
Ja, das ist möglich. Lernt ein Generator bestimmte Muster als besonders charakteristisch, kann er sie in den synthetischen Daten überbetonen. Eine Verzerrung, die in den echten Daten schwach ausgeprägt war, tritt dann deutlicher hervor, ohne dass jemand es beabsichtigt hat. Die verbreitete Annahme, synthetische Daten seien höchstens so verzerrt wie ihre Vorlage, trägt deshalb nicht. Ob sie verzerrter sind, lässt sich nur messen.
Die Grenze der Methode liegt in ihrer Vorlage: Die Qualität synthetischer Daten hängt von der Erzeugungsmethode und von der Qualität der echten Daten ab, die als Vorlage dienen. Die Methode kann die Vorlage nachbilden, aber nicht verbessern. Warum Datenqualität deshalb vor jedem Modell steht, beschreibt der Beitrag Ohne Datenstrategie keine KI.
Warum Kredit- und Risikomodelle besonders betroffen sind
In Kredit- und Risikomodellen hat eine Verzerrung unmittelbare und rechtlich relevante Folgen. Benachteiligt ein Kreditmodell bestimmte Gruppen systematisch, weil es verzerrte Muster gelernt hat, entstehen Entscheidungen, die rechtlich und ethisch problematisch sind. Die europäische KI-Verordnung stuft in Anhang III KI-Systeme zur Bewertung der Kreditwürdigkeit natürlicher Personen als Hochrisiko-Systeme ein.
Für solche Systeme verlangt Artikel 10 der Verordnung eine Daten-Governance für Trainings-, Validierungs- und Testdaten. Dazu gehören unter anderem die Dokumentation von Datenerhebung und Datenherkunft, die Untersuchung auf mögliche Verzerrungen, die zu verbotener Diskriminierung führen können, und geeignete Maßnahmen, um festgestellte Verzerrungen zu erkennen, zu verhindern und abzuschwächen. Der Hinweis, dass synthetische statt echter Daten verwendet wurden, entlastet dabei nicht. Die Verantwortung für Qualität und Fairness der Modelle bleibt beim Institut, unabhängig davon, ob die Trainingsdaten echt oder synthetisch sind.
Wofür sich synthetische Daten trotzdem lohnen
Synthetische Daten lohnen sich dort, wo echte Daten fehlen oder nicht genutzt werden dürfen. Echte Kundendaten in großer Menge zu beschaffen ist aufwendig und datenschutzrechtlich heikel, und gerade seltene Fälle, die ein Modell lernen müsste, sind in echten Daten oft unterrepräsentiert. Synthetische Daten lassen sich gezielt für seltene Konstellationen erzeugen und bilden keine realen Personen ab. Für Tests, für die Entwicklung und für das Durchspielen von Szenarien ist das ein echter Fortschritt.
Voraussetzung ist eine saubere Trennung: Synthetische Daten müssen gekennzeichnet und von produktiven Beständen getrennt bleiben, damit sie nicht unbemerkt in echte Datenbestände gelangen. Welche Folgen eine solche Vermischung haben kann, beschreibt der Beitrag zur Datenintegrität im Zeitalter generativer KI.
Wie Institute Modelle auf synthetischen Daten prüfen sollten
Ein Modell, das auf synthetischen Daten trainiert wurde, gehört gegen echte Daten validiert. Erst diese Validierung zeigt, ob es in der Realität funktioniert und ob es Verzerrungen aufweist. Ohne sie bleibt offen, ob das Modell auf den echten Fällen, die es entscheiden soll, korrekt arbeitet.
Die Validierung muss dabei besonders auf Fairness achten. Es genügt nicht zu prüfen, ob das Modell im Durchschnitt gut entscheidet; geprüft werden muss, ob es für alle relevanten Gruppen angemessen entscheidet. Ein Modell, das im Durchschnitt überzeugt, aber für bestimmte Gruppen systematisch schlechter entscheidet, erfüllt die Anforderungen nicht. Erfahrungen aus der Validierung interner Ratingmodelle lassen sich hier übertragen, wie der Beitrag zum Modellrisiko interner Ratingverfahren zeigt.
Ebenso wichtig ist die Nachvollziehbarkeit. Ein Institut sollte dokumentieren, woher seine synthetischen Daten stammen, mit welcher Methode und aus welcher Vorlage sie erzeugt wurden und welche Prüfungen sie durchlaufen haben. Diese Nachweiskette ist die Grundlage, um gegenüber Revision und Prüfern belegen zu können, dass die Modelle sorgfältig entwickelt wurden. Welche Fragen eine solche Nachweiskette beantworten muss, beschreibt der Beitrag zur Nachweiskette in KI-Projekten.
Warum die Verantwortung beim Institut bleibt
Die Verantwortung bleibt beim Institut, weil sie sich weder an den Anbieter der Methode noch an die Technik delegieren lässt. Synthetische Daten verlocken dazu, schneller und günstiger zu Modellen zu kommen. Werden sie als Grund genutzt, die Prüfung abzukürzen, entsteht ein Risiko, das sich später rächt. Werden sie als Werkzeug genutzt und die Prüfung trotzdem ernst genommen, bringen sie ihren Vorteil, ohne ihre Risiken zu ignorieren. Schneller ja, aber nicht unkontrolliert.
Was das Management festlegen sollte
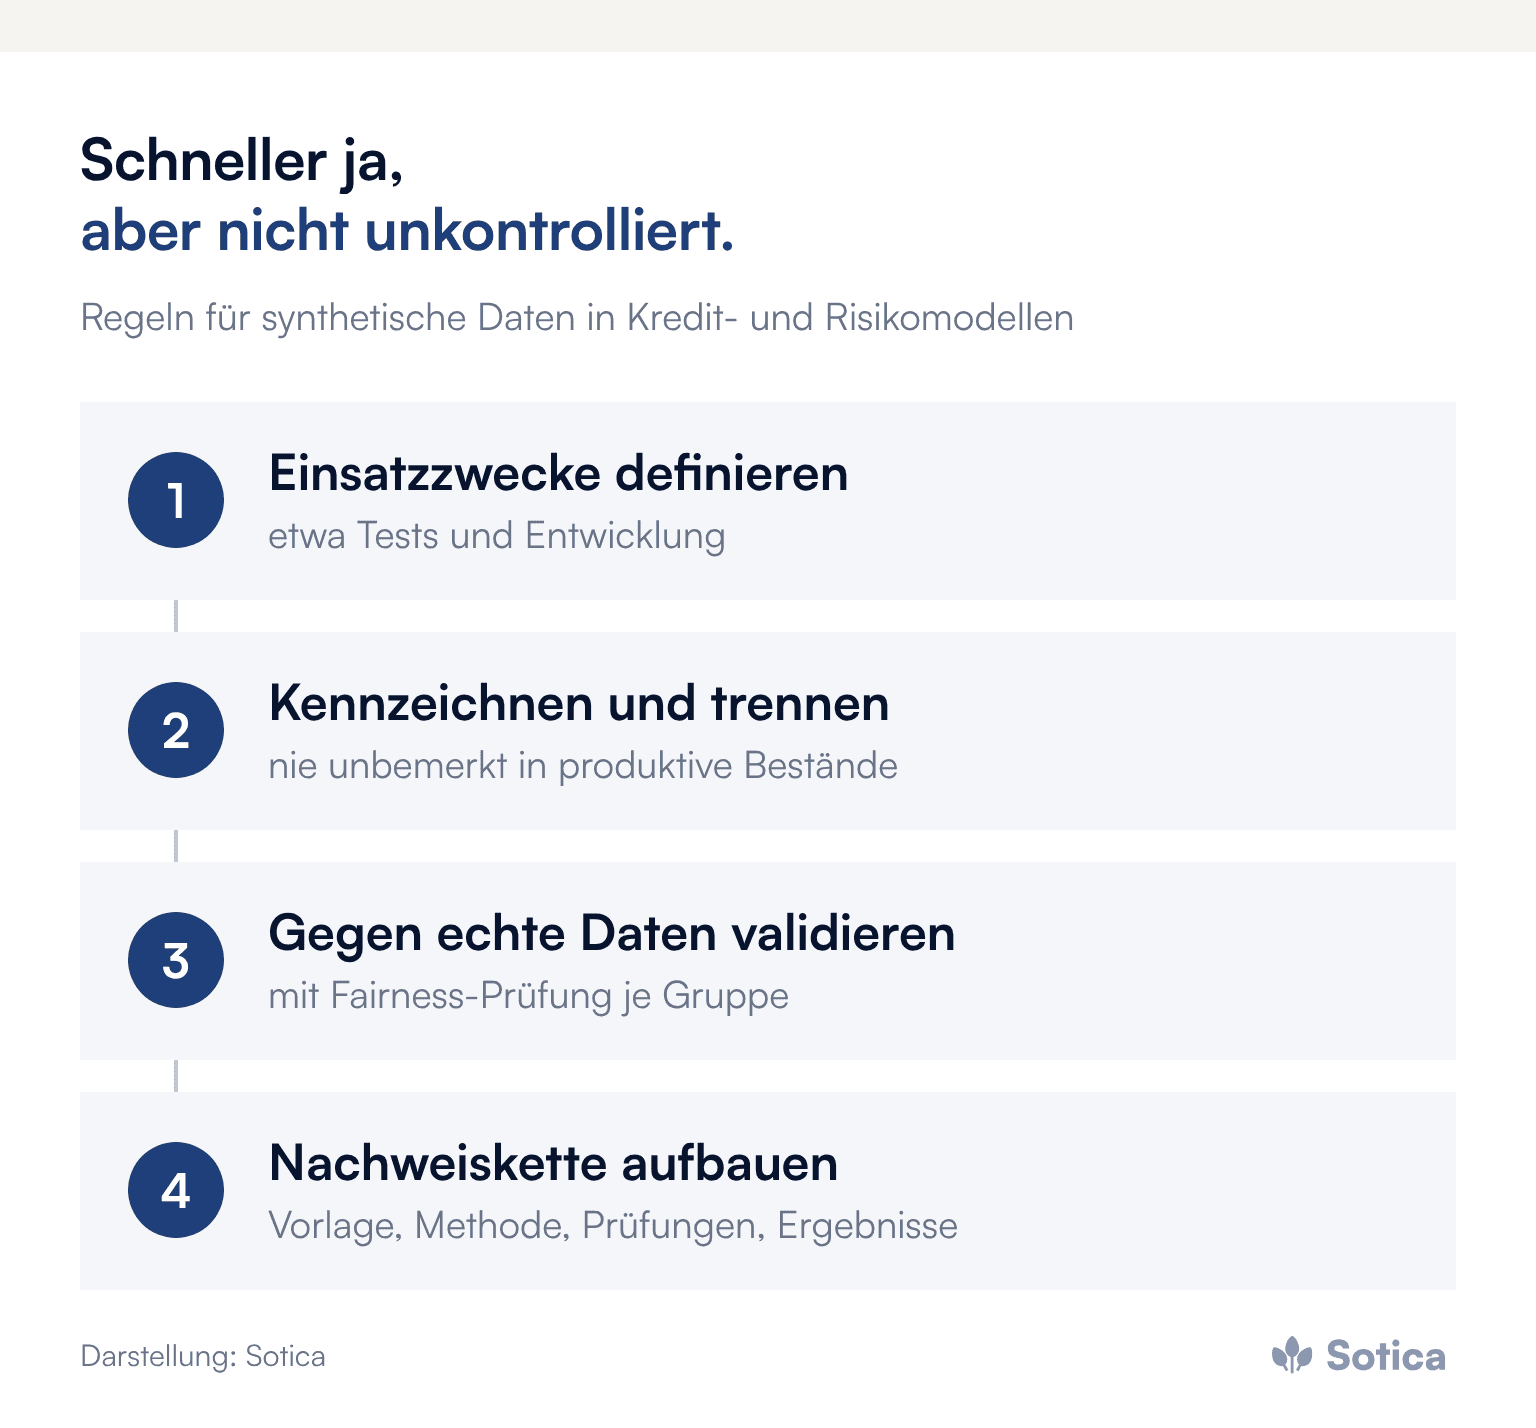
Einsatzzwecke definieren: wofür synthetische Daten genutzt werden dürfen, etwa Tests und Entwicklung, und wofür nicht ohne zusätzliche Prüfung.
Kennzeichnung und Trennung vorschreiben, damit synthetische Daten nie unbemerkt in produktive Bestände gelangen.
Validierung gegen echte Daten zur Pflicht machen, einschließlich Fairness-Prüfung je relevanter Gruppe.
Eine Nachweiskette aufbauen: Vorlage, Methode, Prüfungen und Ergebnisse je Modell dokumentieren.
Häufige Fragen
Was sind synthetische Daten?
Künstlich erzeugte Datensätze, die die statistischen Eigenschaften echter Daten nachbilden, ohne reale Personen abzubilden. Sie werden für Tests, Modellentwicklung und seltene Szenarien genutzt.
Sind synthetische Daten automatisch fairer als echte Daten?
Nein. Sie erben die Muster ihrer Vorlage, einschließlich der Verzerrungen, und können diese sogar verstärken. Fairness muss deshalb gemessen werden.
Dürfen Kreditmodelle mit synthetischen Daten trainiert werden?
Grundsätzlich ja. Systeme zur Bewertung der Kreditwürdigkeit natürlicher Personen gelten nach der KI-Verordnung aber als Hochrisiko-Systeme, für die Anforderungen an Daten-Governance, Prüfung auf Verzerrungen und Dokumentation gelten, unabhängig davon, ob die Trainingsdaten echt oder synthetisch sind.
Weitere Beiträge zu Datenqualität, Datenarchitektur und Kernsystemen bündelt das Dossier Daten & Kernsysteme.
Ob synthetische Daten ein Modell beschleunigen oder nur seine Schwächen verdecken, zeigt sich meist an der Frage, wer die Vorlage zuletzt auf Verzerrungen geprüft hat. Ein erstes Gespräch zu diesem Thema ist uns jederzeit willkommen.

Dominik Winkel
Gründer & Managing Partner, Sotica. Partner für Wandel in der Finanzbranche. Von der Herausforderung bis zur Lösung im Tagesgeschäft.
Thema zurzeit im Fokus?
Im Gespräch ordnen wir Ausgangslage und Handlungsspielraum direkt ein. Unverbindlich und ohne Umwege.


