Insight
Multi-LLM-Strategie: Warum Finanzinstitute nicht auf ein Modell setzen
Warum die feste Bindung an ein Sprachmodell Kosten, Qualität und Datenschutz an einen Anbieter kettet und wie eine austauschbare Architektur aussieht.
Geschäftsmodell und Innovation
6 min Lesezeit
Kernaussage
Wer Anwendungen fest an ein Sprachmodell bindet, bindet Kosten, Qualität und Datenschutz an einen Anbieter. Erst eine eigene Zugriffsschicht mit Routing und Prüfsatz macht Modellentscheidungen revidierbar.

Die wichtigsten Erkenntnisse
Der Modellmarkt verschiebt sich in Monaten
Bindung entsteht durch die Anwendung
Routing ist zugleich Kostenhebel
Ein Modell ist eine Momentaufnahme
Viele KI-Anwendungen in Finanzinstituten sind fest mit einem einzigen Sprachmodell verdrahtet: Anweisungen, Prüfregeln und Schnittstellen sind auf genau dieses Modell zugeschnitten. Das funktioniert, bis sich Preis, Qualität oder Verfügbarkeit ändern, und auf dem Markt für Sprachmodelle ändert sich all das in Monaten, nicht in Jahren.
Eine Multi-LLM-Strategie trennt die Anwendung vom konkreten Sprachmodell, sodass sich Modelle je Aufgabe wählen und ohne Neubau der Anwendung austauschen lassen. Erst diese Austauschbarkeit macht eine Modellentscheidung revidierbar und hält Kosten, Qualität und Datenschutz in der Hand des Instituts.
Wie schnell verschiebt sich der Markt für Sprachmodelle?
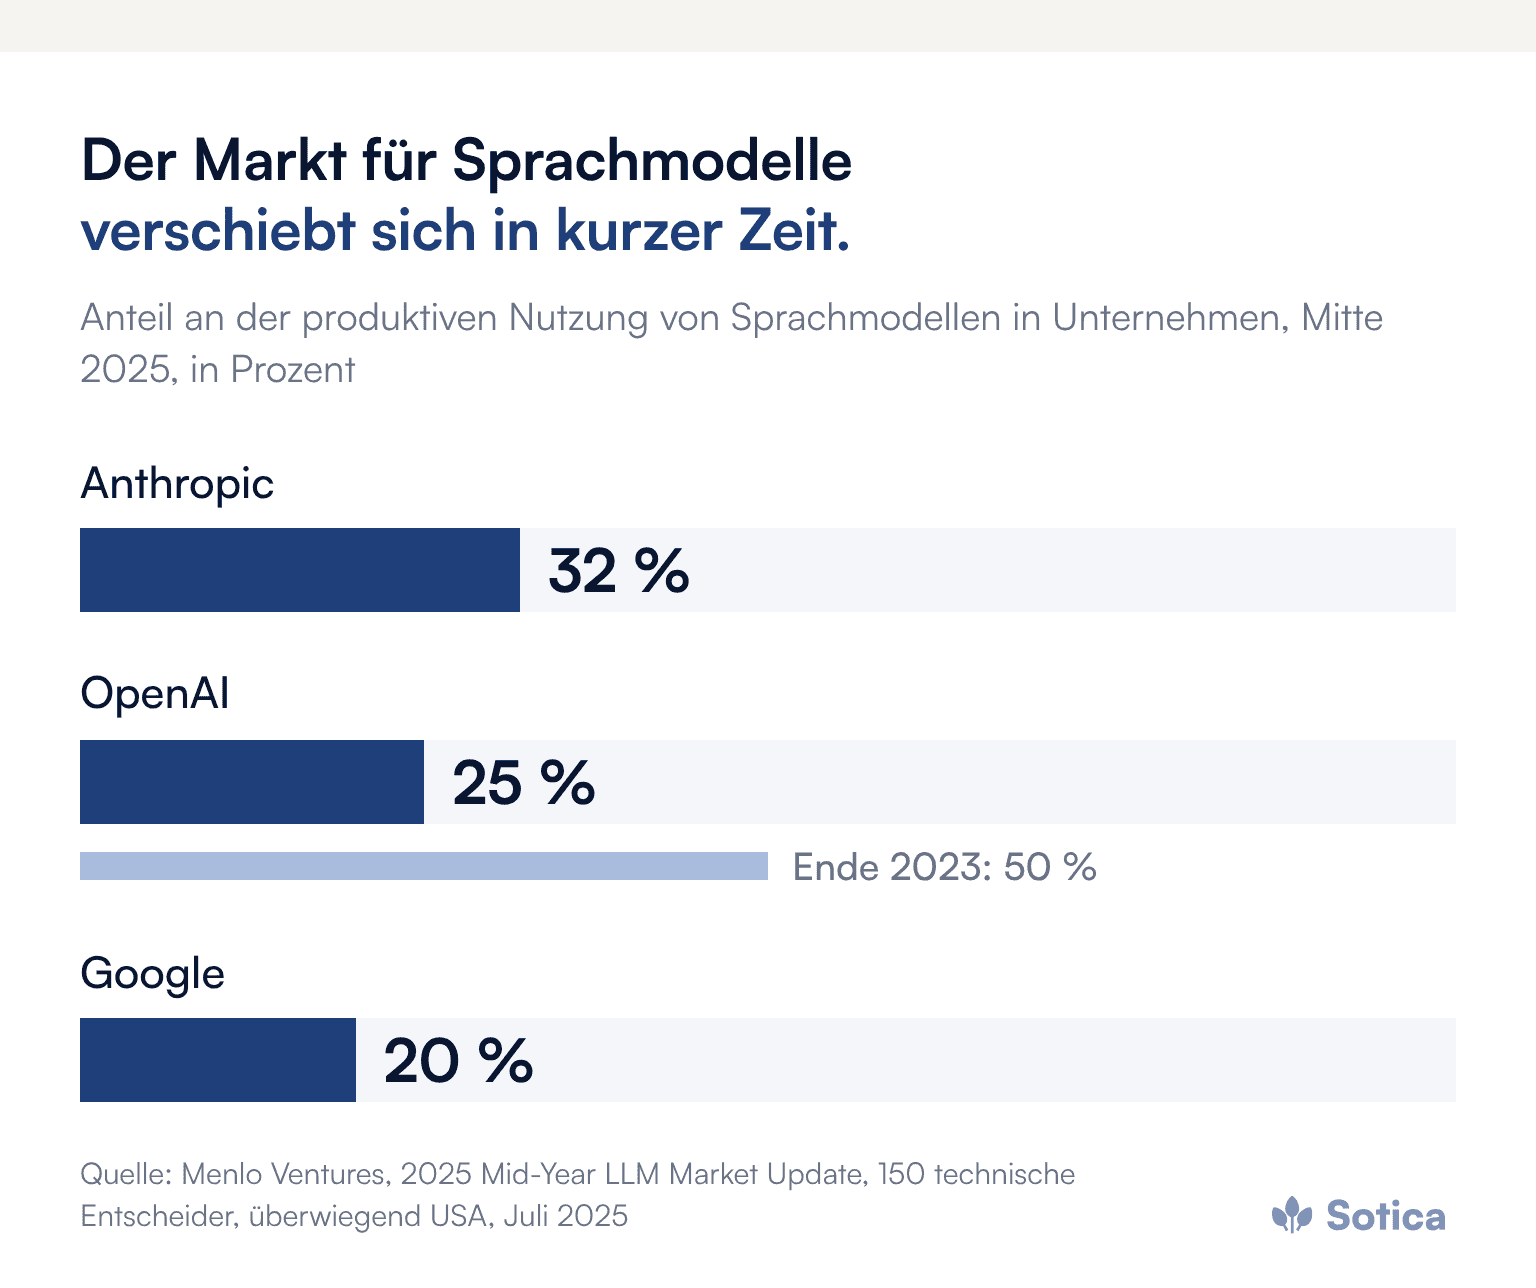
Schneller, als die meisten Implementierungen amortisiert sind. Nach dem „Mid-Year LLM Market Update“ von Menlo Ventures vom Juli 2025, einer Befragung von 150 technischen Entscheidungsträgern vor allem aus dem US-Markt, hielt OpenAI Ende 2023 noch 50 Prozent der produktiven Nutzung von Sprachmodellen in Unternehmen. Mitte 2025 lag Anthropic mit 32 Prozent vorn, OpenAI bei 25 Prozent und Google bei 20 Prozent.
Auch der Abstand zwischen offenen und geschlossenen Modellen schrumpft. Der „AI Index Report 2025“ der Stanford University berichtet, dass der Vorsprung des besten geschlossenen Modells vor dem besten Open-Weight-Modell, also einem Modell mit frei verfügbaren Gewichten, auf einer verbreiteten Vergleichsplattform innerhalb eines Jahres von 8,0 auf 1,7 Prozent gesunken ist. Für Institute mit hohem Schutzbedarf werden damit Modelle interessant, die sich auf eigener Infrastruktur betreiben lassen.
Warum ist die Festlegung auf ein Modell riskant?
Weil sie in jeder Dimension Abhängigkeit schafft:
Kosten: Steigt der Preis des Modells oder wird ein günstigeres gleichwertiges verfügbar, kann die Anwendung nicht reagieren.
Qualität: Ändert sich das Verhalten eines Modells mit einer neuen Version, trägt die Anwendung das Risiko ohne Ausweichmöglichkeit.
Verfügbarkeit: Modelle haben einen Lebenszyklus. Anthropic etwa kündigt die Abschaltung öffentlich verfügbarer Modelle mit mindestens 60 Tagen Vorlauf an; Claude 3.7 Sonnet wurde im Oktober 2025 abgekündigt und im Februar 2026 abgeschaltet.
Datenschutz: Bei sensiblen Daten gelten die Bedingungen des einen Anbieters, auch wenn ein lokal betriebenes Modell die Aufgabe ebenso erledigen könnte.
Bemerkenswert ist, wie selten Unternehmen tatsächlich wechseln: Nach Menlo Ventures haben nur 11 Prozent der befragten Teams im vergangenen Jahr den Modellanbieter gewechselt, zwei Drittel sind auf neuere Modelle desselben Anbieters umgestiegen. Die Bindung entsteht weniger durch Verträge als durch Anwendungen, die nur mit einem Modell funktionieren.
Was gehört zu einer Multi-LLM-Architektur?
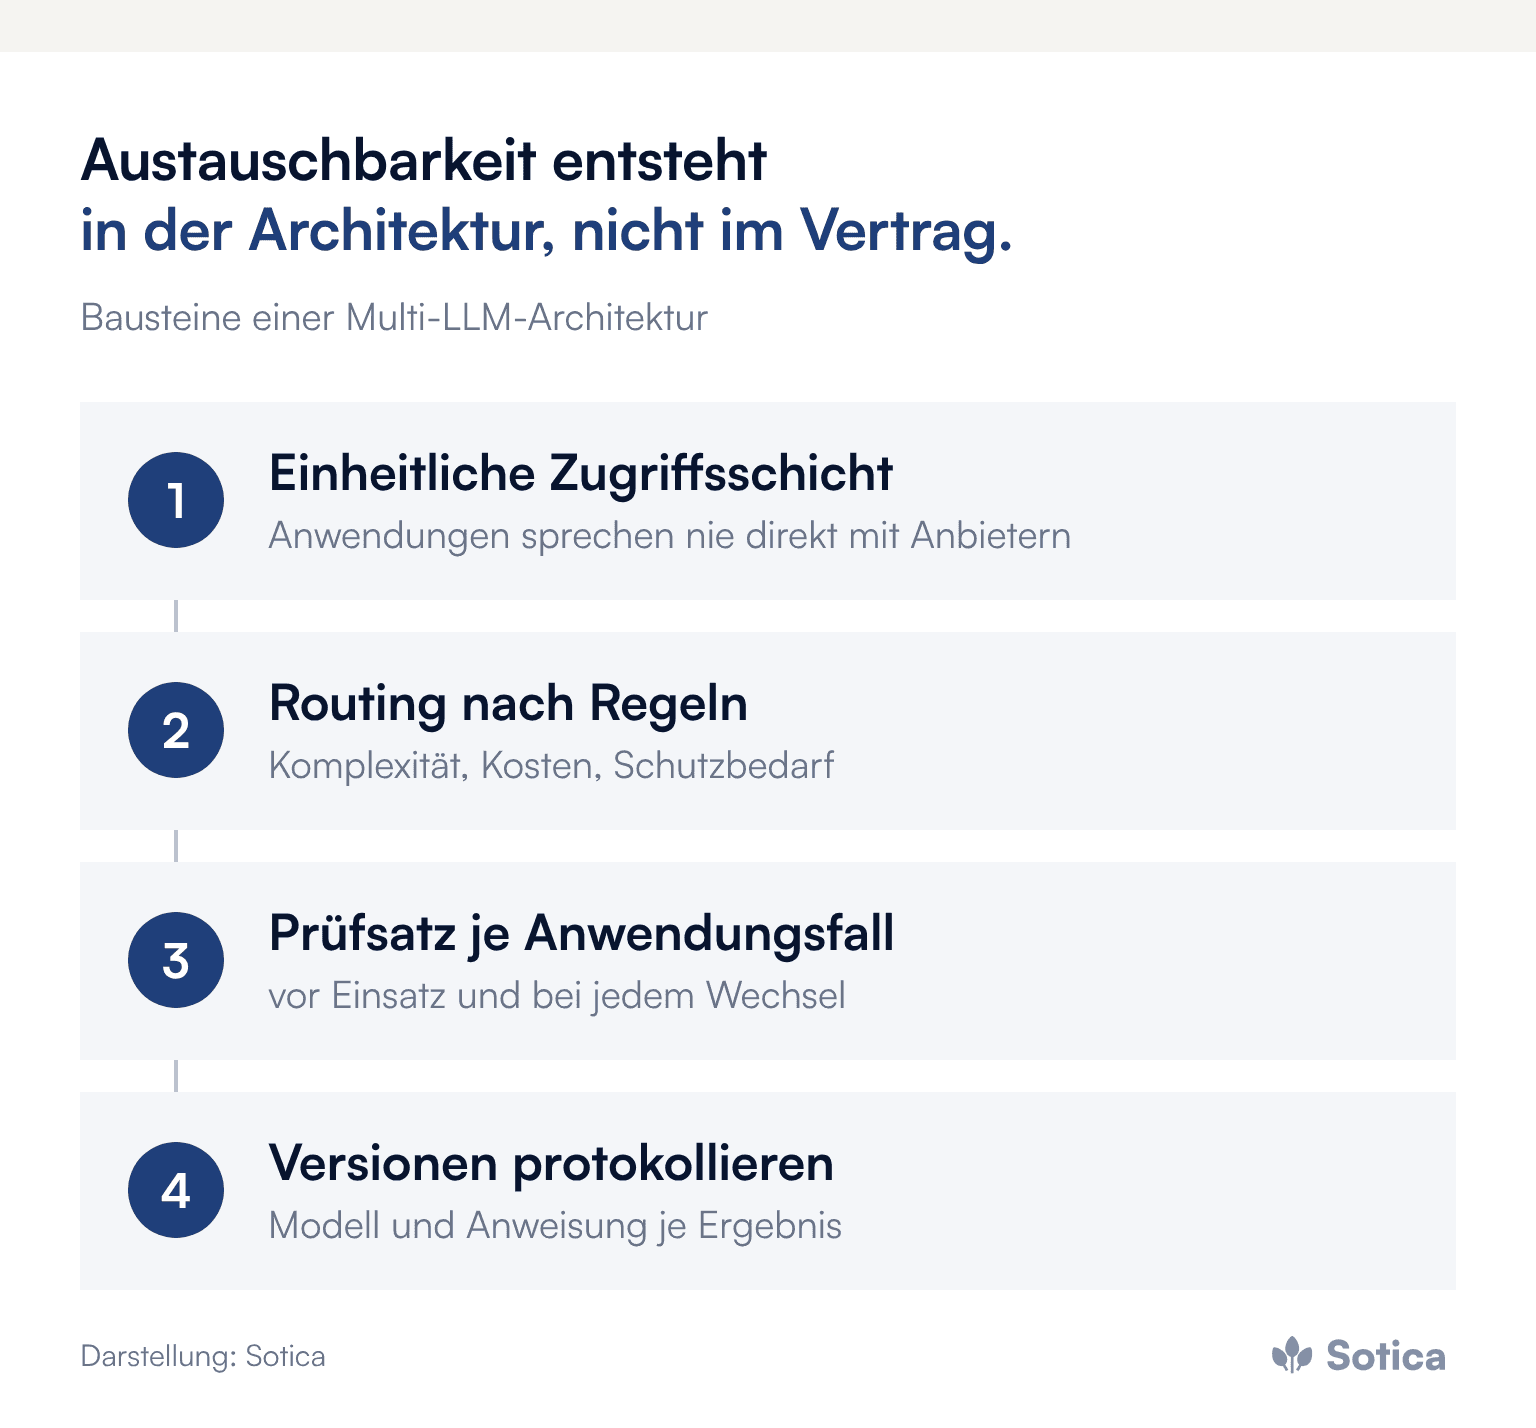
Drei Bausteine. Im Kern steht eine Abstraktionsschicht zwischen Anwendung und Modell: Die Anwendung ruft eine einheitliche Schnittstelle auf, hinter der sich das Modell tauschen lässt. Darauf setzt ein Routing auf, das jede Anfrage nach festen Regeln an ein passendes Modell weitergibt, einfache Aufgaben an ein kleines, günstiges Modell, komplexe an ein großes, sensible Daten an ein lokal betriebenes. Der dritte Baustein ist ein Prüfsatz aus echten Fällen, mit dem jedes Modell vor dem Einsatz und bei jedem Wechsel gemessen wird.
Wie das im Verbund aussieht, zeigt der S-KIPilot der Finanz Informatik. Nach einem Praxisbericht im IT-Finanzmagazin vom Juli 2026 wählt ein automatisches Routing je nach Art der Anfrage, ob Text, Dokument oder Audio, ein spezialisiertes Modell aus, ohne dass sich die Oberfläche ändert. Neben dem ursprünglichen Modell von Mistral wurden weitere Modelle wie Mistral Small und gpt-oss-120b von OpenAI ergänzt, ohne die Infrastruktur neu zu gestalten. Die Multi-LLM-Strategie unterscheidet sich damit von der reinen Auswahl eines KI-Anbieters: Es geht um Austauschbarkeit auf der Modellebene selbst.
Zwei Details entscheiden in der Praxis, ob der Austausch tatsächlich gelingt. Erstens werden Anweisungen an das Modell, die sogenannten Prompts, nicht im Programmcode verstreut, sondern zentral und je Modell versioniert abgelegt, weil verschiedene Modelle auf dieselbe Anweisung unterschiedlich reagieren. Zweitens protokolliert die Anwendung zu jedem Ergebnis, welches Modell in welcher Version es erzeugt hat. Nur so lässt sich später nachvollziehen, ob eine Qualitätsveränderung am Modell, an den Daten oder an der Anweisung liegt.
Welchen Beitrag leistet das Routing zur Kostensteuerung?
Einen erheblichen, weil nicht jede Anfrage das größte Modell braucht. Eine Zusammenfassung oder Klassifikation erledigt ein kleines Modell oft ebenso gut wie ein großes, zu einem Bruchteil der Kosten je Vorgang. Routing wird damit zu einem zentralen Instrument der FinOps-Steuerung für KI. Wer hier differenziert, senkt die Betriebskosten, ohne an Qualität zu verlieren, wo sie zählt; der Prüfsatz zeigt, wo diese Grenze liegt.
Wie passt das zu DORA und Souveränität?
Gut, denn beide verlangen Ausweichmöglichkeiten. DORA fordert in Artikel 29 vor Vertragsschluss eine Bewertung des Konzentrationsrisikos, also ob ein Anbieter nicht ohne Weiteres ersetzbar ist, und eine Abwägung von Nutzen und Kosten alternativer Lösungen wie dem Einsatz mehrerer Anbieter. Eine Architektur, in der sich Modelle tauschen lassen, liefert dafür die technische Grundlage. Warum Souveränität sich an der Austauschbarkeit entscheidet und nicht an der Herkunft eines Modells, beschreibt der Beitrag zur KI-Souveränität; wie die Wahl zwischen lokalem Betrieb und Cloud ausfällt, der Beitrag zu lokalen KI-Modellen und Cloud-KI.
Was das Management für die eigene KI-Architektur festlegen sollte
Austauschbarkeit als Architekturprinzip beschließen: Neue Anwendungen greifen nur über eine einheitliche Schnittstelle auf Sprachmodelle zu.
Einen Prüfsatz je Anwendungsfall aufbauen, mit dem jedes Modell vor Einsatz und bei jedem Wechsel gemessen wird.
Routing-Regeln festlegen, die Aufgaben nach Komplexität, Kosten und Schutzbedarf der Daten zuordnen.
Den Modellbestand jährlich überprüfen und dabei Qualität, Kosten und Abkündigungen der Anbieter bewerten.
Den Modellwechsel im Ausstiegsplan nach DORA verankern, mit Verantwortung, Testverfahren und Übergangszeit.
Häufige Fragen
Was ist eine Multi-LLM-Strategie?
Eine Architektur, in der eine Anwendung über eine einheitliche Schnittstelle auf mehrere Sprachmodelle zugreift und je Aufgabe das passende Modell nutzt, statt fest an eines gebunden zu sein.
Macht der Einsatz mehrerer Modelle den Betrieb nicht komplizierter?
Etwas, aber beherrschbar: Mit Abstraktionsschicht, festen Routing-Regeln und einem gemeinsamen Prüfsatz bleibt der Aufwand überschaubar und deutlich kleiner als ein erzwungener Neubau.
Wie oft wechseln Unternehmen tatsächlich ihr Sprachmodell?
Nach Menlo Ventures (2025) haben nur 11 Prozent der befragten Teams im vergangenen Jahr den Anbieter gewechselt; die meisten bleiben beim bisherigen Anbieter und nutzen dessen neuere Modelle.
Eingebettet gehört die Multi-LLM-Strategie in den KI-Stack der Bank und in die grundsätzliche Plattformentscheidung. Weitere Beiträge bündelt das Dossier KI-Strategie & Plattformen.
Wie viel Aufwand ein Modellwechsel in der eigenen Anwendungslandschaft auslösen würde, zeigt, wie frei die nächste KI-Entscheidung tatsächlich ist. Wir freuen uns auf ein erstes Gespräch über diese Fragen.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.
Die wichtigsten Erkenntnisse
Der Modellmarkt verschiebt sich in Monaten
Bindung entsteht durch die Anwendung
Routing ist zugleich Kostenhebel
Ein Modell ist eine Momentaufnahme
Viele KI-Anwendungen in Finanzinstituten sind fest mit einem einzigen Sprachmodell verdrahtet: Anweisungen, Prüfregeln und Schnittstellen sind auf genau dieses Modell zugeschnitten. Das funktioniert, bis sich Preis, Qualität oder Verfügbarkeit ändern, und auf dem Markt für Sprachmodelle ändert sich all das in Monaten, nicht in Jahren.
Eine Multi-LLM-Strategie trennt die Anwendung vom konkreten Sprachmodell, sodass sich Modelle je Aufgabe wählen und ohne Neubau der Anwendung austauschen lassen. Erst diese Austauschbarkeit macht eine Modellentscheidung revidierbar und hält Kosten, Qualität und Datenschutz in der Hand des Instituts.
Wie schnell verschiebt sich der Markt für Sprachmodelle?
Schneller, als die meisten Implementierungen amortisiert sind. Nach dem „Mid-Year LLM Market Update“ von Menlo Ventures vom Juli 2025, einer Befragung von 150 technischen Entscheidungsträgern vor allem aus dem US-Markt, hielt OpenAI Ende 2023 noch 50 Prozent der produktiven Nutzung von Sprachmodellen in Unternehmen. Mitte 2025 lag Anthropic mit 32 Prozent vorn, OpenAI bei 25 Prozent und Google bei 20 Prozent.
Auch der Abstand zwischen offenen und geschlossenen Modellen schrumpft. Der „AI Index Report 2025“ der Stanford University berichtet, dass der Vorsprung des besten geschlossenen Modells vor dem besten Open-Weight-Modell, also einem Modell mit frei verfügbaren Gewichten, auf einer verbreiteten Vergleichsplattform innerhalb eines Jahres von 8,0 auf 1,7 Prozent gesunken ist. Für Institute mit hohem Schutzbedarf werden damit Modelle interessant, die sich auf eigener Infrastruktur betreiben lassen.
Warum ist die Festlegung auf ein Modell riskant?
Weil sie in jeder Dimension Abhängigkeit schafft:
Kosten: Steigt der Preis des Modells oder wird ein günstigeres gleichwertiges verfügbar, kann die Anwendung nicht reagieren.
Qualität: Ändert sich das Verhalten eines Modells mit einer neuen Version, trägt die Anwendung das Risiko ohne Ausweichmöglichkeit.
Verfügbarkeit: Modelle haben einen Lebenszyklus. Anthropic etwa kündigt die Abschaltung öffentlich verfügbarer Modelle mit mindestens 60 Tagen Vorlauf an; Claude 3.7 Sonnet wurde im Oktober 2025 abgekündigt und im Februar 2026 abgeschaltet.
Datenschutz: Bei sensiblen Daten gelten die Bedingungen des einen Anbieters, auch wenn ein lokal betriebenes Modell die Aufgabe ebenso erledigen könnte.
Bemerkenswert ist, wie selten Unternehmen tatsächlich wechseln: Nach Menlo Ventures haben nur 11 Prozent der befragten Teams im vergangenen Jahr den Modellanbieter gewechselt, zwei Drittel sind auf neuere Modelle desselben Anbieters umgestiegen. Die Bindung entsteht weniger durch Verträge als durch Anwendungen, die nur mit einem Modell funktionieren.
Was gehört zu einer Multi-LLM-Architektur?
Drei Bausteine. Im Kern steht eine Abstraktionsschicht zwischen Anwendung und Modell: Die Anwendung ruft eine einheitliche Schnittstelle auf, hinter der sich das Modell tauschen lässt. Darauf setzt ein Routing auf, das jede Anfrage nach festen Regeln an ein passendes Modell weitergibt, einfache Aufgaben an ein kleines, günstiges Modell, komplexe an ein großes, sensible Daten an ein lokal betriebenes. Der dritte Baustein ist ein Prüfsatz aus echten Fällen, mit dem jedes Modell vor dem Einsatz und bei jedem Wechsel gemessen wird.
Wie das im Verbund aussieht, zeigt der S-KIPilot der Finanz Informatik. Nach einem Praxisbericht im IT-Finanzmagazin vom Juli 2026 wählt ein automatisches Routing je nach Art der Anfrage, ob Text, Dokument oder Audio, ein spezialisiertes Modell aus, ohne dass sich die Oberfläche ändert. Neben dem ursprünglichen Modell von Mistral wurden weitere Modelle wie Mistral Small und gpt-oss-120b von OpenAI ergänzt, ohne die Infrastruktur neu zu gestalten. Die Multi-LLM-Strategie unterscheidet sich damit von der reinen Auswahl eines KI-Anbieters: Es geht um Austauschbarkeit auf der Modellebene selbst.
Zwei Details entscheiden in der Praxis, ob der Austausch tatsächlich gelingt. Erstens werden Anweisungen an das Modell, die sogenannten Prompts, nicht im Programmcode verstreut, sondern zentral und je Modell versioniert abgelegt, weil verschiedene Modelle auf dieselbe Anweisung unterschiedlich reagieren. Zweitens protokolliert die Anwendung zu jedem Ergebnis, welches Modell in welcher Version es erzeugt hat. Nur so lässt sich später nachvollziehen, ob eine Qualitätsveränderung am Modell, an den Daten oder an der Anweisung liegt.
Welchen Beitrag leistet das Routing zur Kostensteuerung?
Einen erheblichen, weil nicht jede Anfrage das größte Modell braucht. Eine Zusammenfassung oder Klassifikation erledigt ein kleines Modell oft ebenso gut wie ein großes, zu einem Bruchteil der Kosten je Vorgang. Routing wird damit zu einem zentralen Instrument der FinOps-Steuerung für KI. Wer hier differenziert, senkt die Betriebskosten, ohne an Qualität zu verlieren, wo sie zählt; der Prüfsatz zeigt, wo diese Grenze liegt.
Wie passt das zu DORA und Souveränität?
Gut, denn beide verlangen Ausweichmöglichkeiten. DORA fordert in Artikel 29 vor Vertragsschluss eine Bewertung des Konzentrationsrisikos, also ob ein Anbieter nicht ohne Weiteres ersetzbar ist, und eine Abwägung von Nutzen und Kosten alternativer Lösungen wie dem Einsatz mehrerer Anbieter. Eine Architektur, in der sich Modelle tauschen lassen, liefert dafür die technische Grundlage. Warum Souveränität sich an der Austauschbarkeit entscheidet und nicht an der Herkunft eines Modells, beschreibt der Beitrag zur KI-Souveränität; wie die Wahl zwischen lokalem Betrieb und Cloud ausfällt, der Beitrag zu lokalen KI-Modellen und Cloud-KI.
Was das Management für die eigene KI-Architektur festlegen sollte
Austauschbarkeit als Architekturprinzip beschließen: Neue Anwendungen greifen nur über eine einheitliche Schnittstelle auf Sprachmodelle zu.
Einen Prüfsatz je Anwendungsfall aufbauen, mit dem jedes Modell vor Einsatz und bei jedem Wechsel gemessen wird.
Routing-Regeln festlegen, die Aufgaben nach Komplexität, Kosten und Schutzbedarf der Daten zuordnen.
Den Modellbestand jährlich überprüfen und dabei Qualität, Kosten und Abkündigungen der Anbieter bewerten.
Den Modellwechsel im Ausstiegsplan nach DORA verankern, mit Verantwortung, Testverfahren und Übergangszeit.
Häufige Fragen
Was ist eine Multi-LLM-Strategie?
Eine Architektur, in der eine Anwendung über eine einheitliche Schnittstelle auf mehrere Sprachmodelle zugreift und je Aufgabe das passende Modell nutzt, statt fest an eines gebunden zu sein.
Macht der Einsatz mehrerer Modelle den Betrieb nicht komplizierter?
Etwas, aber beherrschbar: Mit Abstraktionsschicht, festen Routing-Regeln und einem gemeinsamen Prüfsatz bleibt der Aufwand überschaubar und deutlich kleiner als ein erzwungener Neubau.
Wie oft wechseln Unternehmen tatsächlich ihr Sprachmodell?
Nach Menlo Ventures (2025) haben nur 11 Prozent der befragten Teams im vergangenen Jahr den Anbieter gewechselt; die meisten bleiben beim bisherigen Anbieter und nutzen dessen neuere Modelle.
Eingebettet gehört die Multi-LLM-Strategie in den KI-Stack der Bank und in die grundsätzliche Plattformentscheidung. Weitere Beiträge bündelt das Dossier KI-Strategie & Plattformen.
Wie viel Aufwand ein Modellwechsel in der eigenen Anwendungslandschaft auslösen würde, zeigt, wie frei die nächste KI-Entscheidung tatsächlich ist. Wir freuen uns auf ein erstes Gespräch über diese Fragen.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.


