Insight
Prompt Injection: Wenn der Chatbot der Bank zur Sicherheitslücke wird
Prompt Injection führt die OWASP-Risikoliste für Sprachmodelle an. Wie Banken Chatbots und Dokumenten-KI mit minimalen Rechten und Freigaben absichern.
Organisation und Kultur
6 min Lesezeit
Kernaussage
Ein Sprachmodell befolgt Anweisungen auch dann, wenn sie aus einem eingereichten Dokument stammen. Wer Rechte begrenzt, fremde Inhalte trennt und kritische Schritte freigeben lässt, nimmt Manipulation die Wirkung.

Die wichtigsten Erkenntnisse
Prompt Injection ist Risiko Nummer eins bei LLMs
Indirekte Angriffe kommen über Dokumente
Minimale Rechte sind der wichtigste Hebel
Wenn die Eingabe das Modell umprogrammiert
Sprachmodelle folgen Anweisungen, und genau das lässt sich ausnutzen. Prompt Injection bezeichnet die Manipulation eines Modells über präparierte Eingaben oder Dokumente, die ihm neue, unerwünschte Anweisungen unterschieben. In kundennahen Bankanwendungen und in der Dokumentenverarbeitung ist das kein theoretisches Randthema: Ein Sprachmodell befolgt Anweisungen auch dann, wenn sie aus einem eingereichten Dokument stammen, und ein erfolgreich manipuliertes Modell kann Daten preisgeben, festgelegte Regeln umgehen oder falsche Auskünfte als korrekt ausgeben. Schutz entsteht deshalb nicht im Modell allein, sondern in Berechtigungen, Datentrennung und menschlicher Freigabe.
Für Banken verbindet sich das technische Risiko unmittelbar mit Verantwortung gegenüber Kundschaft und Aufsicht. Sicherheit gehört deshalb in die Governance jeder KI-Anwendung, von Anfang an.
Wie verbreitet ist das Risiko?
Es steht an erster Stelle der bekannten Risiken für Sprachmodell-Anwendungen. Das Open Worldwide Application Security Project (OWASP), eine gemeinnützige Initiative für Anwendungssicherheit, führt Prompt Injection in seiner Top-10-Liste für Anwendungen mit großen Sprachmodellen von 2025 als Risiko LLM01. Nach OWASP können Eingaben ein Modell auch dann beeinflussen, wenn sie für Menschen nicht sichtbar oder lesbar sind, solange das Modell sie verarbeitet. Ob es überhaupt narrensichere Vorbeugung gibt, hält OWASP angesichts der Funktionsweise generativer KI für unklar; Maßnahmen können die Folgen aber deutlich begrenzen.
Die BaFin beschreibt verwandte Angriffe im Bericht „Risiken im Fokus 2026“ als technische Schwachstellen durch KI: Bei sogenannten Evasion Attacks werden Schutzmaßnahmen eines Modells durch gezielt veränderte Eingaben umgangen, sodass es Schadcode erzeugt oder vertrauliche Daten preisgibt. Daneben nennt sie manipulierte Trainingsdaten und Angriffe, die vertrauliche Informationen aus Trainingsdaten extrahieren sollen. Unternehmen müssen ihre KI-Modelle schützen, etwa mit Inhaltsfiltern und einer Überwachung des Modellverhaltens.
Wie sieht ein Angriff aus?
Direkt im Chat oder indirekt über Dokumente. Bei der direkten Variante schreibt jemand eine Anweisung in den Chat, die das System dazu bringen soll, seine ursprünglichen Vorgaben zu ignorieren. Gefährlicher ist die indirekte Variante: Eine Anweisung steckt in einem Dokument, einer Website oder einer E-Mail, die die Anwendung ohnehin verarbeitet. Das Modell liest sie, ohne dass ein Mensch sie bemerkt, und führt sie aus.
Gerade in der Dokumentenverarbeitung der Marktfolge ist dieser Weg relevant, weil Systeme dort Unterlagen aus unkontrollierter Herkunft verarbeiten: Gehaltsnachweise, Jahresabschlüsse, Schriftverkehr. OWASP weist zudem darauf hin, dass multimodale Modelle zusätzliche Angriffsflächen bieten, etwa wenn Anweisungen in Bildern versteckt werden, die harmlosen Text begleiten. Verwandt damit ist die Gefahr manipulierter Trainings- oder Eingabedaten, beschrieben im Beitrag zu Datenintegrität und Poisoning.
Warum sind Banken besonders exponiert?
Drei Eigenschaften erhöhen das Risiko. Kundennahe Chatbots sind direkt zugänglich und damit ein offenes Einfallstor. Dokumentenverarbeitende KI-Agenten nehmen Inhalte aus unkontrollierter Herkunft entgegen und sind oft mit Kernsystemen verbunden. Und im Hintergrund liegen sensible Kundendaten und klare Haftung.
Die Folgen hängen nach OWASP stark davon ab, wie viel Handlungsspielraum ein Modell in der Anwendung hat. Ein Assistent, der nur Texte entwirft, richtet bei Manipulation weniger Schaden an als ein KI-Agent, der Stammdaten ändern, Zahlungen vorbereiten oder Dokumente weiterleiten darf. Genau deshalb wird die Frage nach Berechtigungen mit jeder Ausbaustufe von KI-Agenten wichtiger. Auch ein veralteter Chatbot ohne zeitgemäße Kontrollen ist hier ein Risiko.
Viele Institute nutzen Sprachmodelle über externe Anbieter oder Lösungen ihres Rechenzentrums. Die Absicherung im eigenen Prozess bleibt trotzdem Aufgabe des Instituts: Welche Daten ein Modell sehen darf, welche Funktionen es aufrufen kann und wo ein Mensch freigibt, wird in der jeweiligen Anwendung entschieden. Im Gespräch mit Anbietern lohnt deshalb die Frage, wie Systemanweisungen geschützt, externe Inhalte getrennt und Angriffe getestet werden und ob sich Testergebnisse vorlegen lassen.
Was schützt wirksam?
Mehrere Schichten, die sich ergänzen. OWASP nennt unter anderem folgende Maßnahmen: das Verhalten des Modells klar begrenzen, erwartete Ausgabeformate festlegen und prüfen, Ein- und Ausgaben filtern, Berechtigungen nach dem Prinzip minimaler Rechte vergeben, für risikoreiche Aktionen eine menschliche Freigabe verlangen, externe Inhalte getrennt und gekennzeichnet verarbeiten sowie regelmäßig Angriffe simulieren.
Für Banken ist das Prinzip minimaler Rechte der wichtigste Hebel. Funktionen wie Datenabfragen oder Buchungsvorbereitungen laufen über eigene, im Code kontrollierte Schnittstellen und nicht über frei formulierte Modellanweisungen. Kritische Schritte bleiben an eine menschliche Freigabe gebunden. Diese Logik ist dieselbe wie beim Schutz vor KI-gestütztem Phishing und bei der Abwehr von Deepfake-Betrug: Technik allein genügt nicht, es braucht klare Prozesse dahinter.
Wie gehört Sicherheit in die KI-Governance?
Als fester Bestandteil von Anfang an. Für Hochrisiko-KI-Systeme verlangt Artikel 15 der KI-Verordnung Widerstandsfähigkeit gegen Versuche unbefugter Dritter, Nutzung, Ergebnisse oder Leistung durch Ausnutzung von Schwachstellen zu verändern. Für den IKT-Betrieb aller Systeme gilt der Digital Operational Resilience Act (DORA); die BaFin hat im Dezember 2025 eine Orientierungshilfe zu IKT-Risiken beim Einsatz von KI veröffentlicht, die bei der Umsetzung unterstützt. Einzelheiten beschreibt der Beitrag zur BaFin-Orientierungshilfe zu KI unter DORA.
Praktisch heißt das: Sicherheitskontrollen werden im selben Rahmen verankert wie Nachvollziehbarkeit und Datenschutz, eingebettet in eine umfassende GenAI-Governance. Eine Architektur, die jeden Verarbeitungsschritt protokolliert, hilft zusätzlich, Manipulationen zu erkennen und aufzuklären, wie der Beitrag Erklärbare KI reicht nicht zeigt.
Was das Management jetzt veranlassen sollte
Fünf Schritte senken das Risiko spürbar:
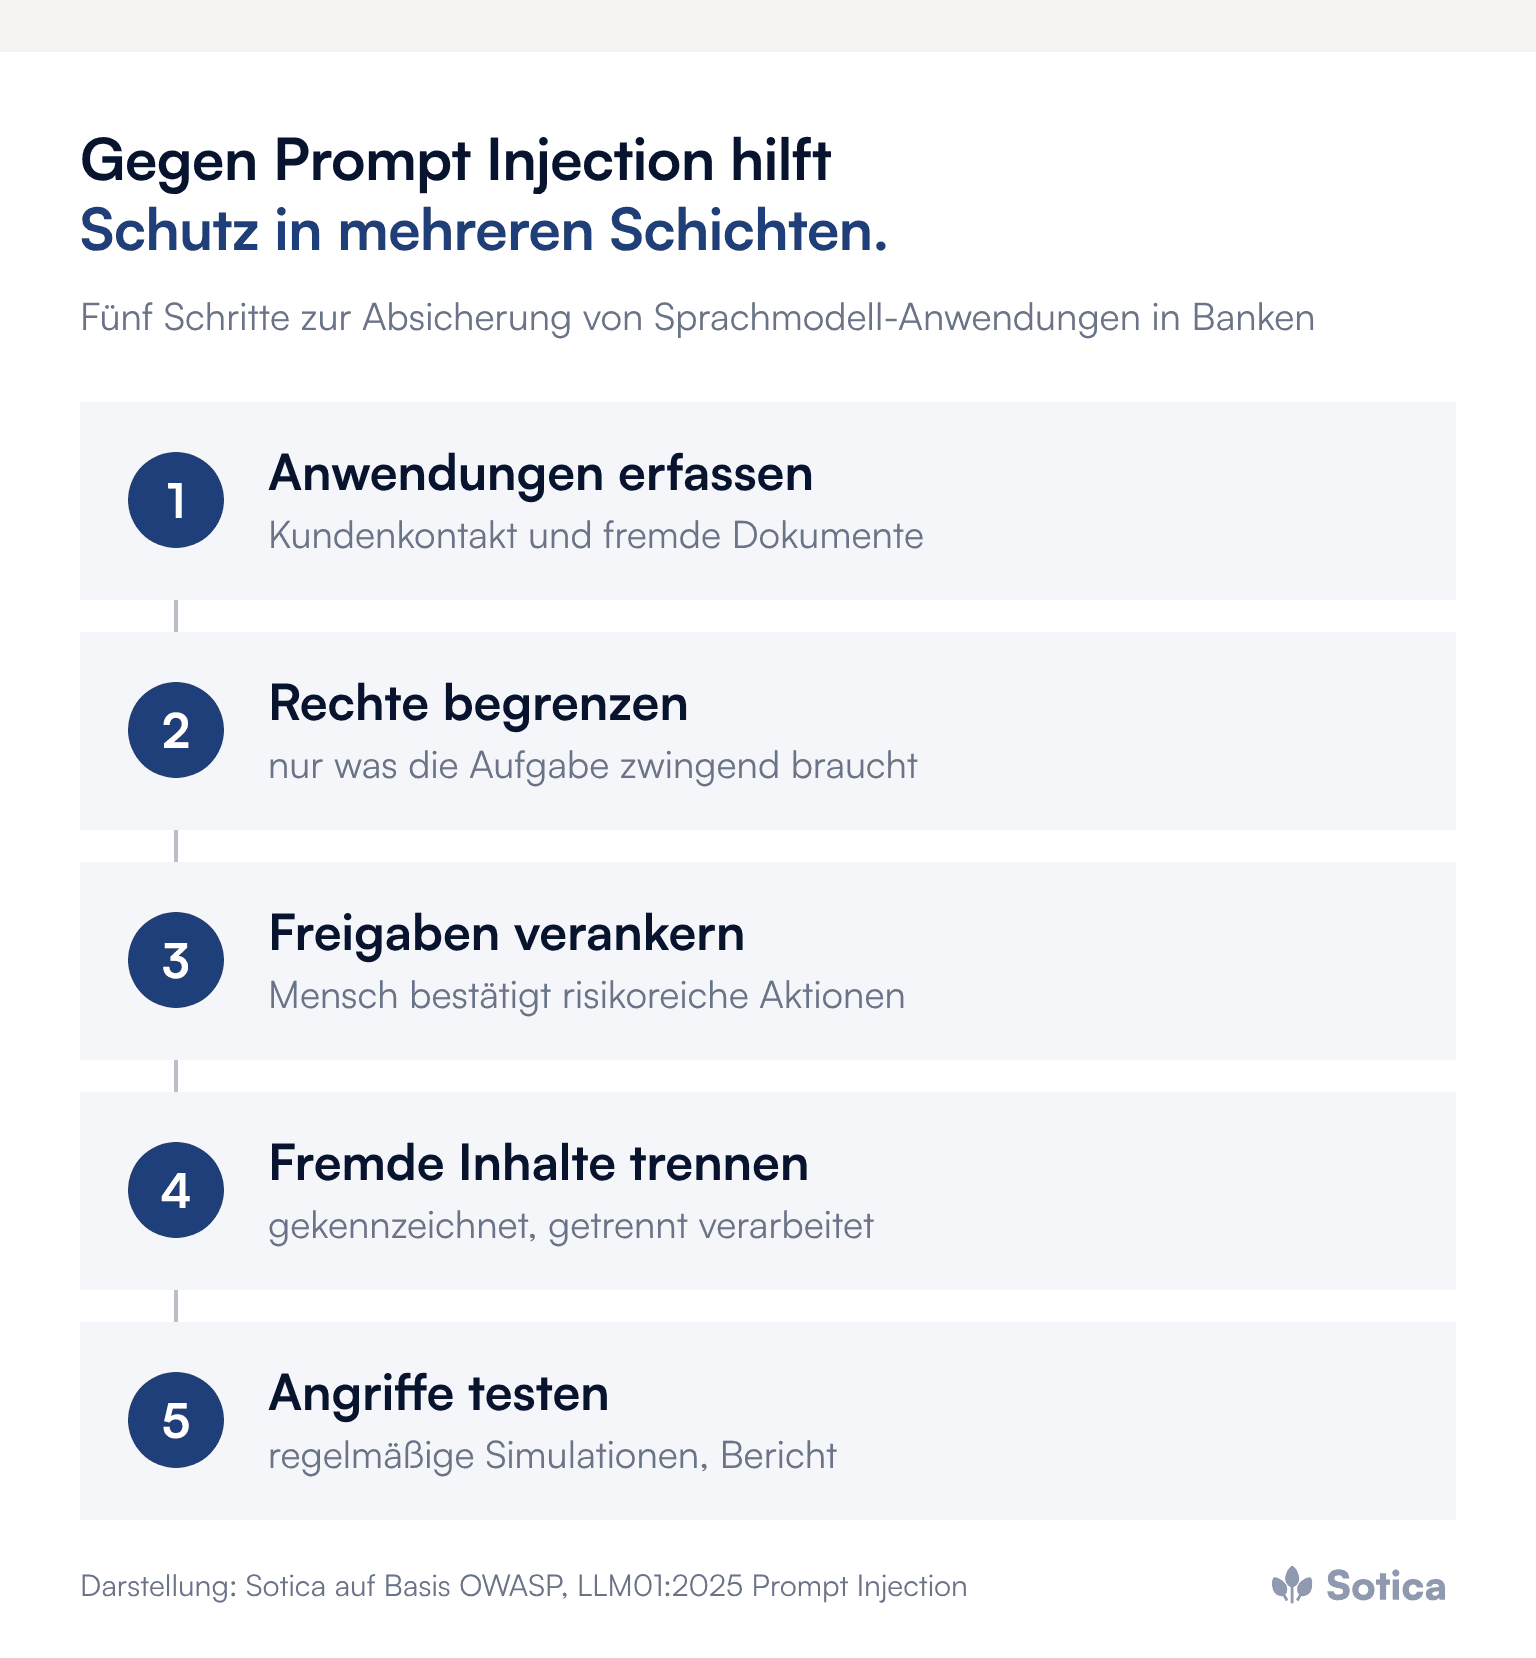
Anwendungen erfassen: alle Sprachmodell-Anwendungen mit Kundenkontakt oder fremden Dokumenten identifizieren.
Rechte begrenzen: Modellen nur die Berechtigungen geben, die sie für ihre Aufgabe zwingend brauchen.
Freigaben verankern: für risikoreiche Aktionen eine menschliche Bestätigung verbindlich vorsehen.
Fremde Inhalte trennen: externe Dokumente und Eingaben gekennzeichnet und getrennt von Systemanweisungen verarbeiten.
Angriffe testen: regelmäßige Angriffssimulationen einplanen und Ergebnisse an das Management berichten.
Häufige Fragen
Was ist Prompt Injection?
Die Manipulation eines Sprachmodells durch Eingaben, die sein Verhalten oder seine Ausgaben unbeabsichtigt verändern, direkt im Chat oder indirekt über verarbeitete Dokumente und Webinhalte.
Lässt sich Prompt Injection vollständig verhindern?
Nach Einschätzung von OWASP ist unklar, ob es narrensichere Vorbeugung gibt. Mehrere Schutzschichten, minimale Rechte und menschliche Freigaben begrenzen die Folgen aber deutlich.
Welche Bankanwendungen sind besonders gefährdet?
Kundennahe Chatbots und KI-Agenten, die fremde Dokumente verarbeiten und mit Kernsystemen verbunden sind, weil sie offene Eingänge mit weitreichenden Rechten verbinden.
Weitere Beiträge zu Cyber-Risiken, Aufsicht und digitaler Resilienz bündelt das Dossier Regulierung & Resilienz.
Wie groß das Risiko im eigenen Institut ist, hängt weniger am Modell als an der Frage, was ein Sprachmodell dort heute ohne menschliche Bestätigung auslösen darf. Gern tauschen wir uns in einem ersten Gespräch dazu aus.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.
Die wichtigsten Erkenntnisse
Prompt Injection ist Risiko Nummer eins bei LLMs
Indirekte Angriffe kommen über Dokumente
Minimale Rechte sind der wichtigste Hebel
Wenn die Eingabe das Modell umprogrammiert
Sprachmodelle folgen Anweisungen, und genau das lässt sich ausnutzen. Prompt Injection bezeichnet die Manipulation eines Modells über präparierte Eingaben oder Dokumente, die ihm neue, unerwünschte Anweisungen unterschieben. In kundennahen Bankanwendungen und in der Dokumentenverarbeitung ist das kein theoretisches Randthema: Ein Sprachmodell befolgt Anweisungen auch dann, wenn sie aus einem eingereichten Dokument stammen, und ein erfolgreich manipuliertes Modell kann Daten preisgeben, festgelegte Regeln umgehen oder falsche Auskünfte als korrekt ausgeben. Schutz entsteht deshalb nicht im Modell allein, sondern in Berechtigungen, Datentrennung und menschlicher Freigabe.
Für Banken verbindet sich das technische Risiko unmittelbar mit Verantwortung gegenüber Kundschaft und Aufsicht. Sicherheit gehört deshalb in die Governance jeder KI-Anwendung, von Anfang an.
Wie verbreitet ist das Risiko?
Es steht an erster Stelle der bekannten Risiken für Sprachmodell-Anwendungen. Das Open Worldwide Application Security Project (OWASP), eine gemeinnützige Initiative für Anwendungssicherheit, führt Prompt Injection in seiner Top-10-Liste für Anwendungen mit großen Sprachmodellen von 2025 als Risiko LLM01. Nach OWASP können Eingaben ein Modell auch dann beeinflussen, wenn sie für Menschen nicht sichtbar oder lesbar sind, solange das Modell sie verarbeitet. Ob es überhaupt narrensichere Vorbeugung gibt, hält OWASP angesichts der Funktionsweise generativer KI für unklar; Maßnahmen können die Folgen aber deutlich begrenzen.
Die BaFin beschreibt verwandte Angriffe im Bericht „Risiken im Fokus 2026“ als technische Schwachstellen durch KI: Bei sogenannten Evasion Attacks werden Schutzmaßnahmen eines Modells durch gezielt veränderte Eingaben umgangen, sodass es Schadcode erzeugt oder vertrauliche Daten preisgibt. Daneben nennt sie manipulierte Trainingsdaten und Angriffe, die vertrauliche Informationen aus Trainingsdaten extrahieren sollen. Unternehmen müssen ihre KI-Modelle schützen, etwa mit Inhaltsfiltern und einer Überwachung des Modellverhaltens.
Wie sieht ein Angriff aus?
Direkt im Chat oder indirekt über Dokumente. Bei der direkten Variante schreibt jemand eine Anweisung in den Chat, die das System dazu bringen soll, seine ursprünglichen Vorgaben zu ignorieren. Gefährlicher ist die indirekte Variante: Eine Anweisung steckt in einem Dokument, einer Website oder einer E-Mail, die die Anwendung ohnehin verarbeitet. Das Modell liest sie, ohne dass ein Mensch sie bemerkt, und führt sie aus.
Gerade in der Dokumentenverarbeitung der Marktfolge ist dieser Weg relevant, weil Systeme dort Unterlagen aus unkontrollierter Herkunft verarbeiten: Gehaltsnachweise, Jahresabschlüsse, Schriftverkehr. OWASP weist zudem darauf hin, dass multimodale Modelle zusätzliche Angriffsflächen bieten, etwa wenn Anweisungen in Bildern versteckt werden, die harmlosen Text begleiten. Verwandt damit ist die Gefahr manipulierter Trainings- oder Eingabedaten, beschrieben im Beitrag zu Datenintegrität und Poisoning.
Warum sind Banken besonders exponiert?
Drei Eigenschaften erhöhen das Risiko. Kundennahe Chatbots sind direkt zugänglich und damit ein offenes Einfallstor. Dokumentenverarbeitende KI-Agenten nehmen Inhalte aus unkontrollierter Herkunft entgegen und sind oft mit Kernsystemen verbunden. Und im Hintergrund liegen sensible Kundendaten und klare Haftung.
Die Folgen hängen nach OWASP stark davon ab, wie viel Handlungsspielraum ein Modell in der Anwendung hat. Ein Assistent, der nur Texte entwirft, richtet bei Manipulation weniger Schaden an als ein KI-Agent, der Stammdaten ändern, Zahlungen vorbereiten oder Dokumente weiterleiten darf. Genau deshalb wird die Frage nach Berechtigungen mit jeder Ausbaustufe von KI-Agenten wichtiger. Auch ein veralteter Chatbot ohne zeitgemäße Kontrollen ist hier ein Risiko.
Viele Institute nutzen Sprachmodelle über externe Anbieter oder Lösungen ihres Rechenzentrums. Die Absicherung im eigenen Prozess bleibt trotzdem Aufgabe des Instituts: Welche Daten ein Modell sehen darf, welche Funktionen es aufrufen kann und wo ein Mensch freigibt, wird in der jeweiligen Anwendung entschieden. Im Gespräch mit Anbietern lohnt deshalb die Frage, wie Systemanweisungen geschützt, externe Inhalte getrennt und Angriffe getestet werden und ob sich Testergebnisse vorlegen lassen.
Was schützt wirksam?
Mehrere Schichten, die sich ergänzen. OWASP nennt unter anderem folgende Maßnahmen: das Verhalten des Modells klar begrenzen, erwartete Ausgabeformate festlegen und prüfen, Ein- und Ausgaben filtern, Berechtigungen nach dem Prinzip minimaler Rechte vergeben, für risikoreiche Aktionen eine menschliche Freigabe verlangen, externe Inhalte getrennt und gekennzeichnet verarbeiten sowie regelmäßig Angriffe simulieren.
Für Banken ist das Prinzip minimaler Rechte der wichtigste Hebel. Funktionen wie Datenabfragen oder Buchungsvorbereitungen laufen über eigene, im Code kontrollierte Schnittstellen und nicht über frei formulierte Modellanweisungen. Kritische Schritte bleiben an eine menschliche Freigabe gebunden. Diese Logik ist dieselbe wie beim Schutz vor KI-gestütztem Phishing und bei der Abwehr von Deepfake-Betrug: Technik allein genügt nicht, es braucht klare Prozesse dahinter.
Wie gehört Sicherheit in die KI-Governance?
Als fester Bestandteil von Anfang an. Für Hochrisiko-KI-Systeme verlangt Artikel 15 der KI-Verordnung Widerstandsfähigkeit gegen Versuche unbefugter Dritter, Nutzung, Ergebnisse oder Leistung durch Ausnutzung von Schwachstellen zu verändern. Für den IKT-Betrieb aller Systeme gilt der Digital Operational Resilience Act (DORA); die BaFin hat im Dezember 2025 eine Orientierungshilfe zu IKT-Risiken beim Einsatz von KI veröffentlicht, die bei der Umsetzung unterstützt. Einzelheiten beschreibt der Beitrag zur BaFin-Orientierungshilfe zu KI unter DORA.
Praktisch heißt das: Sicherheitskontrollen werden im selben Rahmen verankert wie Nachvollziehbarkeit und Datenschutz, eingebettet in eine umfassende GenAI-Governance. Eine Architektur, die jeden Verarbeitungsschritt protokolliert, hilft zusätzlich, Manipulationen zu erkennen und aufzuklären, wie der Beitrag Erklärbare KI reicht nicht zeigt.
Was das Management jetzt veranlassen sollte
Fünf Schritte senken das Risiko spürbar:
Anwendungen erfassen: alle Sprachmodell-Anwendungen mit Kundenkontakt oder fremden Dokumenten identifizieren.
Rechte begrenzen: Modellen nur die Berechtigungen geben, die sie für ihre Aufgabe zwingend brauchen.
Freigaben verankern: für risikoreiche Aktionen eine menschliche Bestätigung verbindlich vorsehen.
Fremde Inhalte trennen: externe Dokumente und Eingaben gekennzeichnet und getrennt von Systemanweisungen verarbeiten.
Angriffe testen: regelmäßige Angriffssimulationen einplanen und Ergebnisse an das Management berichten.
Häufige Fragen
Was ist Prompt Injection?
Die Manipulation eines Sprachmodells durch Eingaben, die sein Verhalten oder seine Ausgaben unbeabsichtigt verändern, direkt im Chat oder indirekt über verarbeitete Dokumente und Webinhalte.
Lässt sich Prompt Injection vollständig verhindern?
Nach Einschätzung von OWASP ist unklar, ob es narrensichere Vorbeugung gibt. Mehrere Schutzschichten, minimale Rechte und menschliche Freigaben begrenzen die Folgen aber deutlich.
Welche Bankanwendungen sind besonders gefährdet?
Kundennahe Chatbots und KI-Agenten, die fremde Dokumente verarbeiten und mit Kernsystemen verbunden sind, weil sie offene Eingänge mit weitreichenden Rechten verbinden.
Weitere Beiträge zu Cyber-Risiken, Aufsicht und digitaler Resilienz bündelt das Dossier Regulierung & Resilienz.
Wie groß das Risiko im eigenen Institut ist, hängt weniger am Modell als an der Frage, was ein Sprachmodell dort heute ohne menschliche Bestätigung auslösen darf. Gern tauschen wir uns in einem ersten Gespräch dazu aus.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.


