Insight
Warum ein Chatbot ohne Quellenanbindung in der Bank nichts wert ist
Warum KI-Assistenten im Finanzinstitut nur mit Quellenanbindung belastbar sind, wer für falsche Auskünfte haftet und woran RAG in der Praxis scheitert.
Geschäftsmodell und Innovation
6 min Lesezeit
Kernaussage
Eine KI-Auskunft ohne Quelle ist im regulierten Prozess nicht prüfbar. Belastbar wird ein Assistent erst durch einen gepflegten, freigegebenen Wissensbestand mit benannten Eigentümern.

Die wichtigsten Erkenntnisse
Für den Chatbot haftet das Unternehmen
RAG bindet Antworten an geprüfte Quellen
Die Arbeit liegt in der Pflege der Quellen
Eine Antwort ohne Quelle ist im regulierten Prozess ein Risiko
Ein Sprachmodell formuliert überzeugend, auch wenn es falsch liegt. Im Alltag eines Finanzinstituts ist das keine Stilfrage: Eine falsche Auskunft zu einer Frist, einer Kondition oder einer Arbeitsanweisung hat Folgen für Kundinnen und Kunden, für die Bearbeitung und im Zweifel für die Haftung des Instituts.
Ein KI-Assistent wird im Finanzinstitut erst belastbar, wenn jede Antwort an einen freigegebenen, gepflegten Wissensbestand gebunden ist und die Quelle mitliefert. Das Verfahren dafür heißt Retrieval Augmented Generation, kurz RAG; die eigentliche Arbeit liegt dabei nicht im Modell, sondern in der Pflege der Quellen.
Wer haftet für die Auskunft eines Chatbots?
Haftbar ist in aller Regel das Unternehmen, das ihn einsetzt. Einen vielzitierten Präzedenzfall hat das Civil Resolution Tribunal der kanadischen Provinz British Columbia im Februar 2024 entschieden. Der Chatbot auf der Website von Air Canada hatte einem Kunden eine Erstattungsregel für Trauerfalltarife beschrieben, die es so nicht gab. Air Canada argumentierte, die richtige Information stehe an anderer Stelle der Website und der Chatbot sei gewissermaßen für sich selbst verantwortlich. Das Tribunal folgte dem nicht: Der Chatbot sei Teil der Website, das Unternehmen hafte für alle Informationen darauf, und Kunden müssten Angaben nicht gegenprüfen. Air Canada musste rund 650 kanadische Dollar Schadenersatz zahlen.
Der Betrag ist klein, das Prinzip nicht. Es ist kanadisches Recht und kein Urteil über Banken, aber es beschreibt eine Erwartung, die auch im deutschen Bankgeschäft gilt: Was ein System des Instituts sagt, sagt das Institut.
Was Retrieval Augmented Generation tatsächlich macht
RAG trennt das Suchen vom Formulieren. Zuerst durchsucht das System einen definierten Wissensbestand, etwa Arbeitsanweisungen, Produktinformationen oder interne Richtlinien, und holt die Textstellen, die zur konkreten Frage passen. Erst danach formuliert das Sprachmodell eine Antwort, und zwar auf Grundlage dieser Stellen, mit Verweis auf die Quelle.
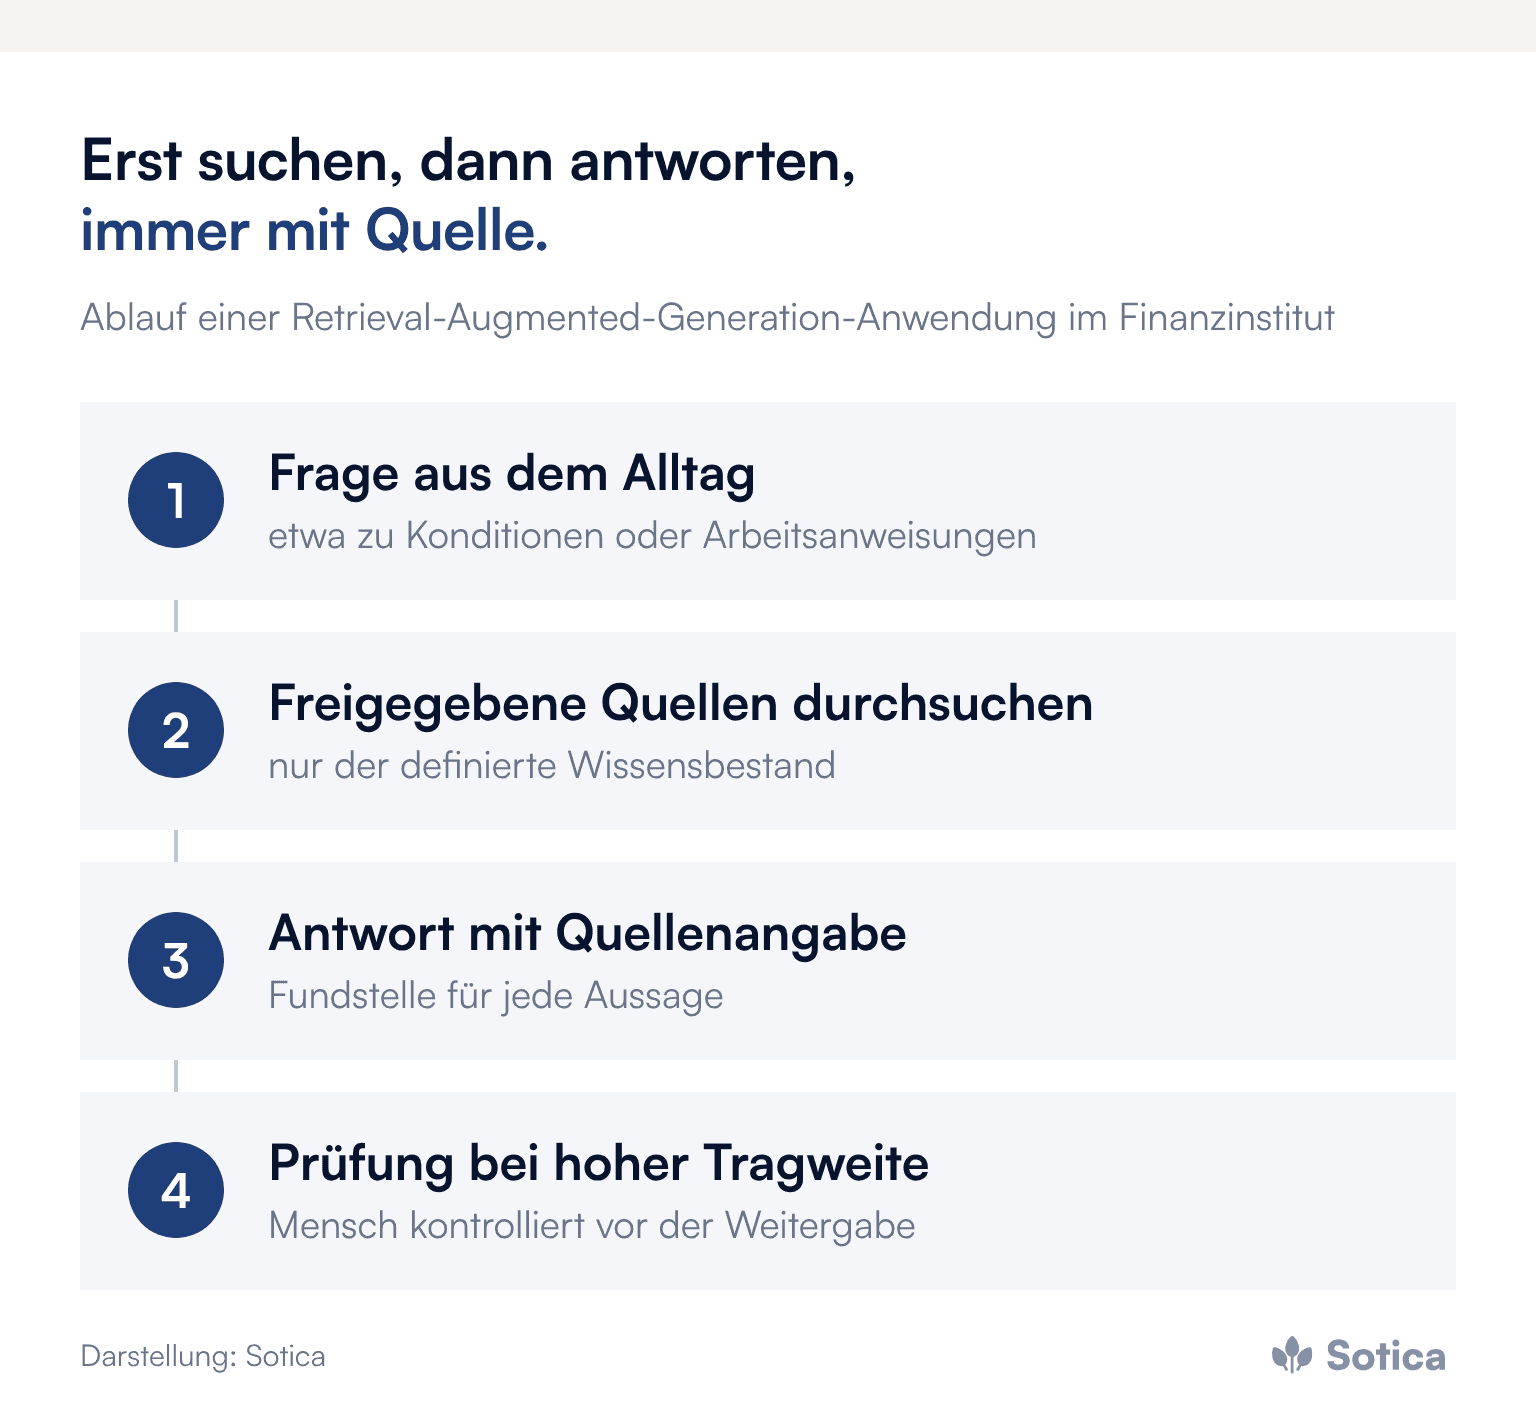
Wie das im Verbund aussieht, zeigt der S-KIPilot der Finanz Informatik. Nach einem Praxisbericht im IT-Finanzmagazin vom Juli 2026 werden Inhalte aus angebundenen Quellen wie dem Prozesssystem PPS_neo und dem Intranet in Abschnitte zerlegt und als Vektoren in einer Suchdatenbank abgelegt; je Sparkasse sind das typischerweise rund 1.000 Prozessdokumente und mehr als 10.000 Wissensbeiträge. Die Antworten sind mit ihren Quellsystemen verknüpft, damit Nutzerinnen und Nutzer sie überprüfen können.
Warum ist die Quellenanbindung im Finanzinstitut die entscheidende Bedingung?
Weil sie drei Anforderungen gleichzeitig erfüllt, die ein frei antwortendes Modell nicht erfüllen kann:
Prüfbarkeit: Wer eine KI-gestützte Auskunft kontrollieren muss, braucht die Stelle, auf der sie beruht. Ohne Quelle bleibt nur die Wahl zwischen blindem Vertrauen und vollständiger Nachrecherche.
Aktualität: Ein gepflegter Wissensbestand lässt sich gezielt ändern, wenn sich eine Kondition oder Vorgabe ändert. Ein Modell ohne Anbindung verharrt auf dem Stand seines Trainings.
Kontrolle über den Inhalt: Das Institut bestimmt, welche Dokumente das System nutzen darf, und schließt aus, dass es Regeln erfindet.
Diese Logik entspricht dem, was die BaFin in ihrer Orientierungshilfe zu IKT-Risiken beim Einsatz von KI vom Dezember 2025 beschreibt: Der gesamte Lebenszyklus eines KI-Systems, von der Datenbeschaffung bis zum Betrieb, gehört in das bestehende IKT-Risikomanagement. Wie dieselbe Idee bei Entscheidungslogiken aussieht, zeigt der Beitrag zur erklärbaren KI, und welche Regeln dafür nötig sind, der Beitrag zur GenAI-Governance in Banken.
Woran scheitert RAG in der Praxis?
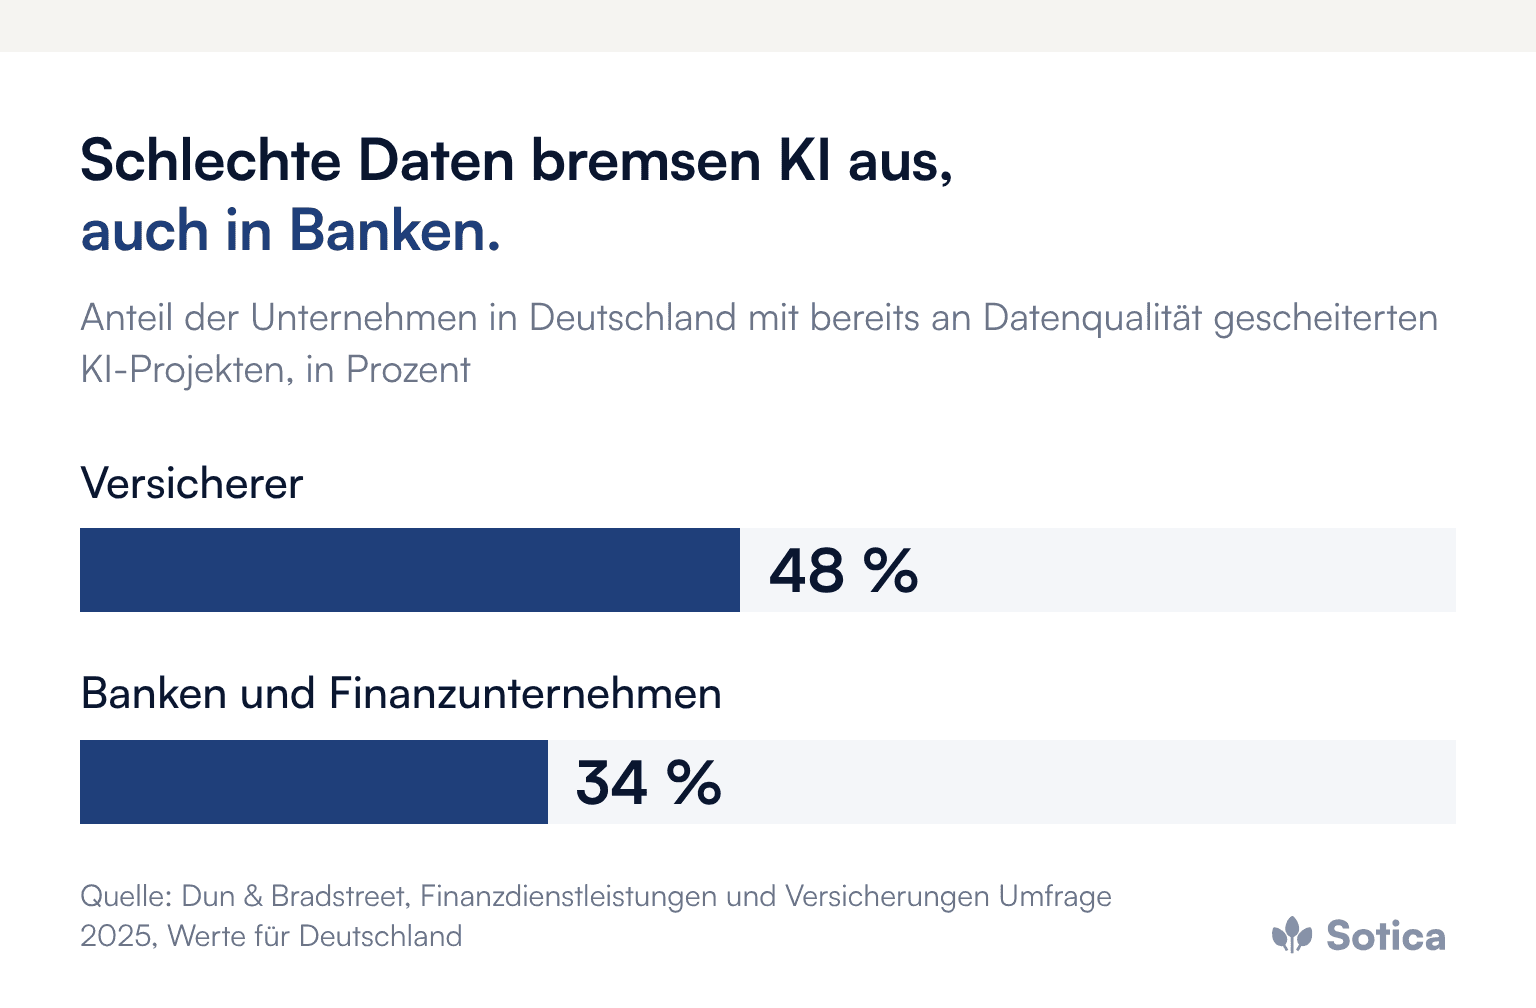
Am Wissensbestand. Ist er unvollständig, widersprüchlich oder veraltet, gibt das System diese Mängel zuverlässig weiter, nur eloquenter. Dass Datenqualität kein Randthema ist, zeigt die „Finanzdienstleistungen und Versicherungen Umfrage 2025“ von Dun & Bradstreet: In Deutschland haben 34 Prozent der Banken und Finanzunternehmen und 48 Prozent der Versicherer bereits KI-Projekte gehabt, die an schlechter Datenqualität gescheitert sind.
Hinzu kommt die Qualität der Suche selbst. Findet das System die falschen Stellen, hilft auch das beste Modell nicht. Typische Ursachen sind mehrere Versionen derselben Arbeitsanweisung, Dokumente ohne klaren Gültigkeitszeitraum und Inhalte, die nur als eingescannte Bilder vorliegen. Warum Antworten so gut sind wie die Datenbasis dahinter, vertieft der Beitrag zur Qualität der Wissensbasis in Sparkassen.
Wie wird aus einem Chatbot eine belastbare Wissensanwendung?
Durch Betrieb, nicht durch Technik allein. Belastbare Wissensanwendungen haben einen benannten Eigentümer für jeden Quellbestand, eine verbindliche Regel, wie neue und geänderte Dokumente aufgenommen und alte entfernt werden, und eine laufende Messung der Antwortqualität an echten Fragen aus dem Alltag. Bei Auskünften mit hoher Tragweite bleibt eine menschliche Prüfung Teil des Ablaufs.
Bewährt hat sich ein fester Prüfsatz: Fachleute sammeln einige Dutzend typische Fragen mit den richtigen Antworten und Fundstellen. Vor jeder größeren Änderung an Quellen, Suche oder Modell läuft dieser Prüfsatz erneut. Sinkt die Trefferquote, wird die Änderung nicht übernommen. So wird Qualität zu einer Zahl, die sich berichten lässt, statt zu einem Eindruck aus Einzelfällen.
So wird aus einem netten, aber unzuverlässigen Chatbot eine Wissensquelle, der die Sachbearbeitung vertrauen kann. Warum gefühltes Vertrauen dafür nicht reicht, zeigt der Beitrag zur Vertrauenslücke bei KI in Banken. Technisch gehört die Anwendung in eine kontrollierte interne KI-Plattform; für sensible Bestände kann auch ein lokaler Betrieb sinnvoll sein, wie das Beispiel lokaler KI in der Marktfolge zeigt.
Was das Management vor dem Start einer Wissensanwendung klären sollte
Den Wissensbestand abgrenzen: Festlegen, welche Dokumente das System nutzen darf und welche ausdrücklich nicht.
Eigentümer je Quelle benennen, die für Aktualität, Versionen und Gültigkeit verantwortlich sind.
Quellenangabe zur Pflicht machen: Keine Antwort ohne Verweis auf die zugrunde liegende Stelle.
Antwortqualität messen an einer Sammlung echter Fragen aus dem Alltag, vor dem Start und danach regelmäßig.
Prüfpflichten festlegen für Auskünfte mit hoher Tragweite, etwa zu Konditionen, Fristen oder Kundenrechten.
Häufige Fragen
Was bedeutet Retrieval Augmented Generation?
Ein Verfahren, bei dem ein KI-System zuerst passende Stellen in einem festgelegten Wissensbestand sucht und erst dann eine Antwort auf dieser Grundlage formuliert, mit Verweis auf die Quelle.
Verhindert RAG falsche Antworten vollständig?
Nein. RAG senkt das Risiko erfundener Inhalte, gibt aber Fehler im Wissensbestand weiter. Deshalb sind Pflege der Quellen und Messung der Antwortqualität Teil des Betriebs.
Haftet ein Institut für falsche Auskünfte seines Chatbots?
Die Rechtslage hängt vom Einzelfall ab. Der Fall Air Canada von 2024 zeigt aber die Grundlinie: Ein Unternehmen kann sich nicht darauf berufen, dass sein Chatbot eigenständig gehandelt habe.
Weitere Beiträge zu Plattformen, Governance und Anwendungsfällen bündelt das Dossier KI-Strategie & Plattformen.
Wie verlässlich ein KI-Assistent antwortet, entscheidet sich meist an der unscheinbaren Frage, wer die dritte Version einer Arbeitsanweisung aus dem Bestand entfernt. Gern kommen wir dazu in einem ersten Gespräch zusammen.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.
Die wichtigsten Erkenntnisse
Für den Chatbot haftet das Unternehmen
RAG bindet Antworten an geprüfte Quellen
Die Arbeit liegt in der Pflege der Quellen
Eine Antwort ohne Quelle ist im regulierten Prozess ein Risiko
Ein Sprachmodell formuliert überzeugend, auch wenn es falsch liegt. Im Alltag eines Finanzinstituts ist das keine Stilfrage: Eine falsche Auskunft zu einer Frist, einer Kondition oder einer Arbeitsanweisung hat Folgen für Kundinnen und Kunden, für die Bearbeitung und im Zweifel für die Haftung des Instituts.
Ein KI-Assistent wird im Finanzinstitut erst belastbar, wenn jede Antwort an einen freigegebenen, gepflegten Wissensbestand gebunden ist und die Quelle mitliefert. Das Verfahren dafür heißt Retrieval Augmented Generation, kurz RAG; die eigentliche Arbeit liegt dabei nicht im Modell, sondern in der Pflege der Quellen.
Wer haftet für die Auskunft eines Chatbots?
Haftbar ist in aller Regel das Unternehmen, das ihn einsetzt. Einen vielzitierten Präzedenzfall hat das Civil Resolution Tribunal der kanadischen Provinz British Columbia im Februar 2024 entschieden. Der Chatbot auf der Website von Air Canada hatte einem Kunden eine Erstattungsregel für Trauerfalltarife beschrieben, die es so nicht gab. Air Canada argumentierte, die richtige Information stehe an anderer Stelle der Website und der Chatbot sei gewissermaßen für sich selbst verantwortlich. Das Tribunal folgte dem nicht: Der Chatbot sei Teil der Website, das Unternehmen hafte für alle Informationen darauf, und Kunden müssten Angaben nicht gegenprüfen. Air Canada musste rund 650 kanadische Dollar Schadenersatz zahlen.
Der Betrag ist klein, das Prinzip nicht. Es ist kanadisches Recht und kein Urteil über Banken, aber es beschreibt eine Erwartung, die auch im deutschen Bankgeschäft gilt: Was ein System des Instituts sagt, sagt das Institut.
Was Retrieval Augmented Generation tatsächlich macht
RAG trennt das Suchen vom Formulieren. Zuerst durchsucht das System einen definierten Wissensbestand, etwa Arbeitsanweisungen, Produktinformationen oder interne Richtlinien, und holt die Textstellen, die zur konkreten Frage passen. Erst danach formuliert das Sprachmodell eine Antwort, und zwar auf Grundlage dieser Stellen, mit Verweis auf die Quelle.
Wie das im Verbund aussieht, zeigt der S-KIPilot der Finanz Informatik. Nach einem Praxisbericht im IT-Finanzmagazin vom Juli 2026 werden Inhalte aus angebundenen Quellen wie dem Prozesssystem PPS_neo und dem Intranet in Abschnitte zerlegt und als Vektoren in einer Suchdatenbank abgelegt; je Sparkasse sind das typischerweise rund 1.000 Prozessdokumente und mehr als 10.000 Wissensbeiträge. Die Antworten sind mit ihren Quellsystemen verknüpft, damit Nutzerinnen und Nutzer sie überprüfen können.
Warum ist die Quellenanbindung im Finanzinstitut die entscheidende Bedingung?
Weil sie drei Anforderungen gleichzeitig erfüllt, die ein frei antwortendes Modell nicht erfüllen kann:
Prüfbarkeit: Wer eine KI-gestützte Auskunft kontrollieren muss, braucht die Stelle, auf der sie beruht. Ohne Quelle bleibt nur die Wahl zwischen blindem Vertrauen und vollständiger Nachrecherche.
Aktualität: Ein gepflegter Wissensbestand lässt sich gezielt ändern, wenn sich eine Kondition oder Vorgabe ändert. Ein Modell ohne Anbindung verharrt auf dem Stand seines Trainings.
Kontrolle über den Inhalt: Das Institut bestimmt, welche Dokumente das System nutzen darf, und schließt aus, dass es Regeln erfindet.
Diese Logik entspricht dem, was die BaFin in ihrer Orientierungshilfe zu IKT-Risiken beim Einsatz von KI vom Dezember 2025 beschreibt: Der gesamte Lebenszyklus eines KI-Systems, von der Datenbeschaffung bis zum Betrieb, gehört in das bestehende IKT-Risikomanagement. Wie dieselbe Idee bei Entscheidungslogiken aussieht, zeigt der Beitrag zur erklärbaren KI, und welche Regeln dafür nötig sind, der Beitrag zur GenAI-Governance in Banken.
Woran scheitert RAG in der Praxis?
Am Wissensbestand. Ist er unvollständig, widersprüchlich oder veraltet, gibt das System diese Mängel zuverlässig weiter, nur eloquenter. Dass Datenqualität kein Randthema ist, zeigt die „Finanzdienstleistungen und Versicherungen Umfrage 2025“ von Dun & Bradstreet: In Deutschland haben 34 Prozent der Banken und Finanzunternehmen und 48 Prozent der Versicherer bereits KI-Projekte gehabt, die an schlechter Datenqualität gescheitert sind.
Hinzu kommt die Qualität der Suche selbst. Findet das System die falschen Stellen, hilft auch das beste Modell nicht. Typische Ursachen sind mehrere Versionen derselben Arbeitsanweisung, Dokumente ohne klaren Gültigkeitszeitraum und Inhalte, die nur als eingescannte Bilder vorliegen. Warum Antworten so gut sind wie die Datenbasis dahinter, vertieft der Beitrag zur Qualität der Wissensbasis in Sparkassen.
Wie wird aus einem Chatbot eine belastbare Wissensanwendung?
Durch Betrieb, nicht durch Technik allein. Belastbare Wissensanwendungen haben einen benannten Eigentümer für jeden Quellbestand, eine verbindliche Regel, wie neue und geänderte Dokumente aufgenommen und alte entfernt werden, und eine laufende Messung der Antwortqualität an echten Fragen aus dem Alltag. Bei Auskünften mit hoher Tragweite bleibt eine menschliche Prüfung Teil des Ablaufs.
Bewährt hat sich ein fester Prüfsatz: Fachleute sammeln einige Dutzend typische Fragen mit den richtigen Antworten und Fundstellen. Vor jeder größeren Änderung an Quellen, Suche oder Modell läuft dieser Prüfsatz erneut. Sinkt die Trefferquote, wird die Änderung nicht übernommen. So wird Qualität zu einer Zahl, die sich berichten lässt, statt zu einem Eindruck aus Einzelfällen.
So wird aus einem netten, aber unzuverlässigen Chatbot eine Wissensquelle, der die Sachbearbeitung vertrauen kann. Warum gefühltes Vertrauen dafür nicht reicht, zeigt der Beitrag zur Vertrauenslücke bei KI in Banken. Technisch gehört die Anwendung in eine kontrollierte interne KI-Plattform; für sensible Bestände kann auch ein lokaler Betrieb sinnvoll sein, wie das Beispiel lokaler KI in der Marktfolge zeigt.
Was das Management vor dem Start einer Wissensanwendung klären sollte
Den Wissensbestand abgrenzen: Festlegen, welche Dokumente das System nutzen darf und welche ausdrücklich nicht.
Eigentümer je Quelle benennen, die für Aktualität, Versionen und Gültigkeit verantwortlich sind.
Quellenangabe zur Pflicht machen: Keine Antwort ohne Verweis auf die zugrunde liegende Stelle.
Antwortqualität messen an einer Sammlung echter Fragen aus dem Alltag, vor dem Start und danach regelmäßig.
Prüfpflichten festlegen für Auskünfte mit hoher Tragweite, etwa zu Konditionen, Fristen oder Kundenrechten.
Häufige Fragen
Was bedeutet Retrieval Augmented Generation?
Ein Verfahren, bei dem ein KI-System zuerst passende Stellen in einem festgelegten Wissensbestand sucht und erst dann eine Antwort auf dieser Grundlage formuliert, mit Verweis auf die Quelle.
Verhindert RAG falsche Antworten vollständig?
Nein. RAG senkt das Risiko erfundener Inhalte, gibt aber Fehler im Wissensbestand weiter. Deshalb sind Pflege der Quellen und Messung der Antwortqualität Teil des Betriebs.
Haftet ein Institut für falsche Auskünfte seines Chatbots?
Die Rechtslage hängt vom Einzelfall ab. Der Fall Air Canada von 2024 zeigt aber die Grundlinie: Ein Unternehmen kann sich nicht darauf berufen, dass sein Chatbot eigenständig gehandelt habe.
Weitere Beiträge zu Plattformen, Governance und Anwendungsfällen bündelt das Dossier KI-Strategie & Plattformen.
Wie verlässlich ein KI-Assistent antwortet, entscheidet sich meist an der unscheinbaren Frage, wer die dritte Version einer Arbeitsanweisung aus dem Bestand entfernt. Gern kommen wir dazu in einem ersten Gespräch zusammen.
Ein Thema, das gerade beschäftigt?
Gemeinsam einordnen, was daraus folgt.


