Insight
Affinitätsmodelle rechnen mit dem, was im Kernbanksystem steht
Affinitätsmodelle bewerten Datensätze, nicht Kunden. Welche drei Bestandsgrößen über gute Vertriebsimpulse entscheiden und wie sie sich vorab messen lassen.
KI & Digitalisierung
6 min Lesezeit
Kernaussage
Ein Vertriebsmodell ist so gut wie der Datensatz, auf dem es rechnet. Wer Affinitäten einführt, ohne Dubletten und Merkmalspflege vorher zu klären, automatisiert seine Datenfehler in die Beratung hinein.

Die wichtigsten Erkenntnisse
Eine Dublette erzeugt zwei Impulse und einen Zweifel.
Datenpflege ist Vertriebsarbeit, nicht IT-Hygiene.
Vier Kennzahlen zeigen den modellfähigen Bestand.
Das Modell ist nicht schlauer als der Datensatz, auf dem es rechnet
Affinitätsmodelle im Bankvertrieb sollen vorhersagen, welcher Kunde gerade für welches Produkt offen ist. Tatsächlich bewerten sie keine Kunden, sondern Datensätze. Die Trefferquote eines Affinitätsmodells hängt deshalb weniger an der Modellgüte als an drei Bestandsgrößen im Kernbanksystem: Dublettenfreiheit, korrekte Betreuerzuordnung und gepflegte Kundenmerkmale.
Warum Datenqualität im Vertrieb unterschätzt wird
Datenqualität gilt als IT-Thema und landet deshalb selten auf der Vertriebsagenda. Die Befunde sprechen gegen diese Zuordnung. In der FS&I-Umfrage 2025 von Dun & Bradstreet unter mehr als 2.000 Führungskräften aus Finanz- und Versicherungsunternehmen in fünf Ländern zählen doppelte Datensätze mit 59 Prozent zu den zentralen Datenherausforderungen. In Deutschland vertrauen 43 Prozent der Befragten ihren eigenen Daten nicht.
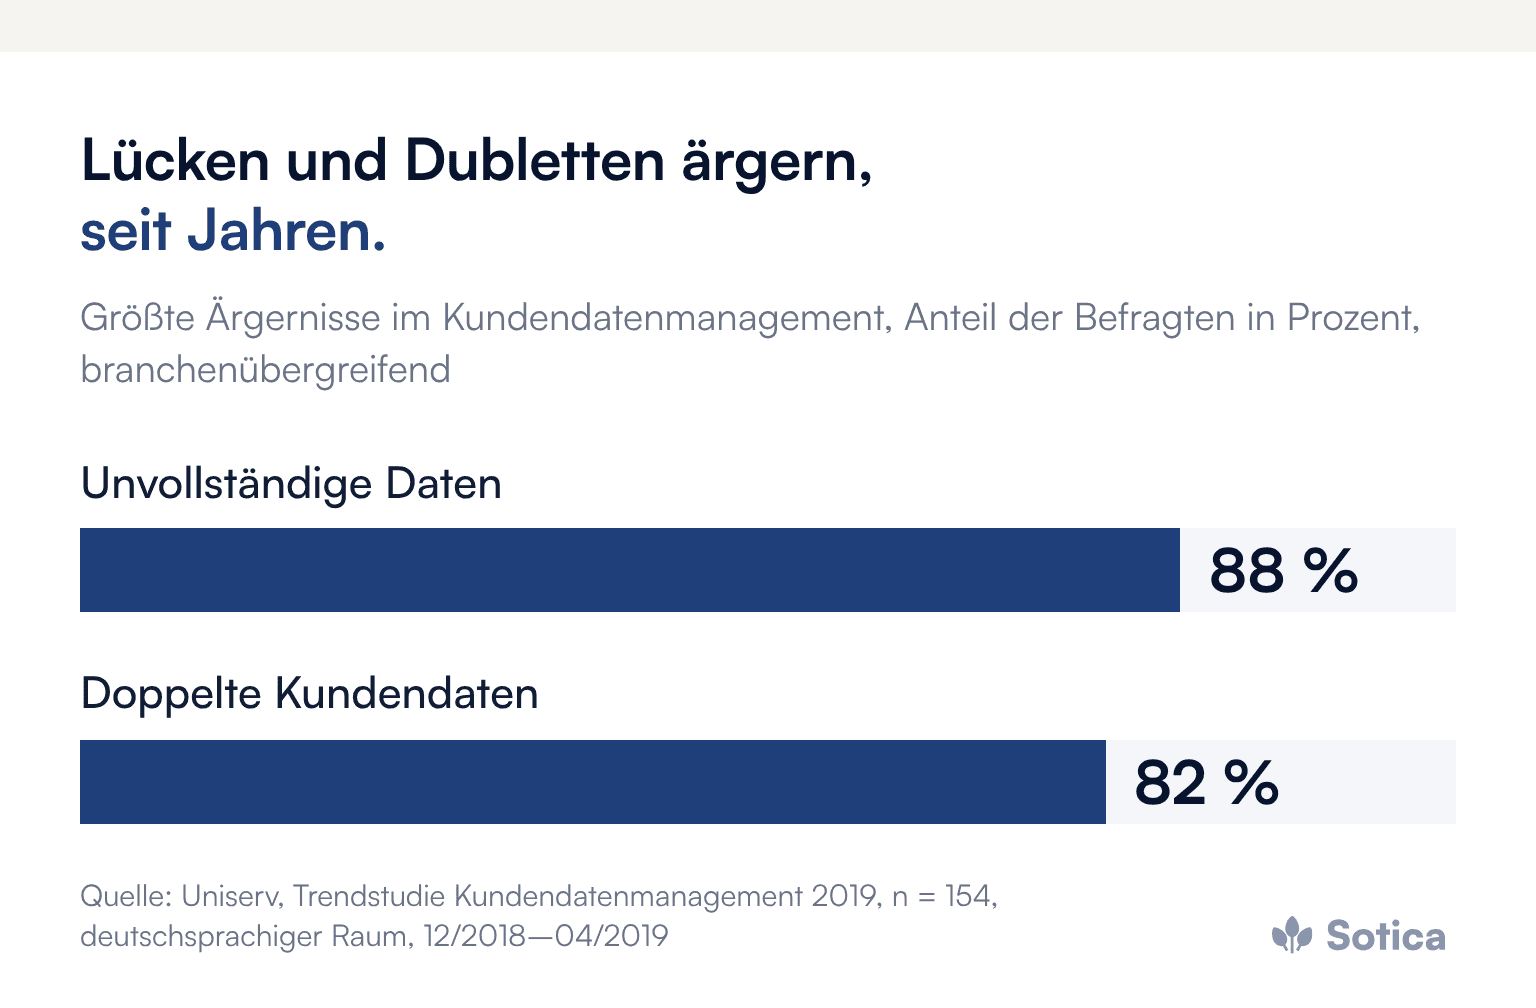
Neu ist das Problem nicht. In der „Trendstudie Kundendatenmanagement 2019“ von Uniserv, für die 154 Fach- und Führungskräfte aus Unternehmen im deutschsprachigen Raum befragt wurden, nannten 88 Prozent unvollständige Daten und 82 Prozent doppelte Kundendaten als Ärgernis. Von den Unternehmen ohne Maßnahmen zur Datenqualität begründeten jeweils 76 Prozent das mit fehlender Kapazität und fehlender Priorität.
Für Affinitätsmodelle ist das mehr als ein Schönheitsfehler. Jede Lücke und jede Dublette verändert, welcher Impuls beim Berater ankommt. Warum Datenqualität deshalb vor jedem KI-Anwendungsfall steht, beschreibt der Beitrag Ohne Datenstrategie keine KI.
Was eine Dublette im Impulsprozess anrichtet
Ein doppelt geführter Kunde erzeugt zwei Impulse, die an zwei Berater gehen. Im günstigen Fall bemerkt es jemand. Im ungünstigen Fall wird der Kunde zweimal zum selben Anlass angesprochen und zieht daraus den Schluss, dass seine Bank ihn nicht kennt.
Der Schaden im Institut ist größer als der beim Kunden. Ein Berater, der zweimal einen offensichtlich falschen Impuls erhalten hat, bewertet die Liste ab dem dritten Mal anders. Diese Bewertung hält länger als jede Korrektur im Datenbestand, und sie entscheidet darüber, ob der datengestützte Vertrieb in der Fläche angenommen wird.
Welche drei Datenfelder für Affinitätsmodelle zuerst zählen
Drei Bereiche des Bestands bestimmen, ob ein Affinitätsmodell brauchbare Impulse liefert:
Dubletten: doppelt geführte Personen und Haushalte, häufig entstanden aus abweichenden Namensschreibweisen, Umzügen und Fusionen.
Betreuerzuordnung: Verwaiste oder veraltete Zuordnungen führen dazu, dass Impulse an niemanden oder an die falsche Person gehen.
Kundenmerkmale: Beruf, Familienstand, Beschäftigungsverhältnis und bevorzugter Kontaktkanal sind die Felder, auf denen Affinitäten rechnen. Sie altern still.
Diese drei Bereiche haben eine Gemeinsamkeit: Fehler darin fallen im Tagesgeschäft niemandem auf. Ein falscher Beruf blockiert keinen Prozess und löst keine Fehlermeldung aus. Er verändert nur, welchen Impuls das Modell erzeugt.
Warum Datenpflege in den Vertrieb gehört
Datenpflege gehört in den Vertrieb, weil Kundenmerkmale im Gespräch bekannt werden, nicht in einer Datenbank. Wird die Pflege an die IT verschoben, trennt sie sich von der einzigen Stelle, an der die Information entsteht. Ein Beratungsprozess, der die Pflege dieser Felder nicht vorsieht, produziert jeden Monat neue Lücken, unabhängig davon, wie gründlich der Bestand einmal bereinigt wurde.
Der Einwand aus der Fläche lautet meist, für Datenpflege sei im Beratungsgespräch keine Zeit. Er stimmt, solange die Pflege als eigener Arbeitsschritt gedacht ist. Er stimmt nicht mehr, sobald sie an Informationen gekoppelt wird, die im Gespräch ohnehin fallen. Ein Kunde, der von seinem Stellenwechsel erzählt, hat das Berufsmerkmal bereits geliefert. Entscheidend ist, ob der Beratungsvorgang an dieser Stelle ein Feld anbietet oder ob die Information in einer Freitextnotiz endet, aus der kein Modell je etwas ableiten kann.
Bestand einmal bereinigen oder laufend pflegen?
Beides ist nötig, in dieser Reihenfolge, aber mit unterschiedlicher Verbindlichkeit. Eine einmalige Bereinigung ist ein Projekt mit Ende, die laufende Pflege eine Prozessänderung ohne Ende. Institute, die nur bereinigen, stehen nach einiger Zeit wieder am Anfang und schließen daraus fälschlich, dass Bereinigung nichts bringt.
Die tragfähige Variante koppelt die Pflege an einen ohnehin stattfindenden Anlass: das Jahresgespräch, die Kontoeröffnung, die Kreditvorlage. Jeder dieser Momente aktualisiert wenige Felder, dafür verlässlich.
Wer bei der Dublettenbereinigung entscheidet
Die Dublettensuche lässt sich maschinell erledigen, die Entscheidung darüber nicht. Welcher von zwei Datensätzen der führende ist, welche Betreuerzuordnung bleibt und welche Historie mitwandert, sind fachliche Entscheidungen. Sie fallen in nennenswerter Zahl und brauchen jemanden, der die Kunden kennt.
Institute, die den Schritt vollständig an die IT geben, bekommen ein technisch sauberes Ergebnis mit fachlichen Fehlern, die erst im Beratungsgespräch auffallen. Sinnvoll ist ein geteiltes Vorgehen: maschinelle Vorschlagsliste, fachliche Entscheidung durch den zuständigen Marktbereich, fester Termin für den Abschluss. Wie sich Datenverantwortung grundsätzlich in die Fachbereiche verlagern lässt, beschreibt der Beitrag zu Data Mesh in der Finanzwirtschaft.
Was eine Fusion mit dem Datenbestand macht
Zusammenschlüsse gehören zu den größten Treibern für Dubletten und verwaiste Zuordnungen. Zwei Institute bringen zwei Schreibweisen, zwei Merkmalskataloge und zwei Betreuerlogiken mit, und die Migration entscheidet in kurzer Zeit über Felder, die vorher jahrelang gewachsen sind. Warum Migrationen deshalb Prozessarbeit sind, zeigt der Beitrag zur Kernbank-Migration bei Atruvia und Finanz Informatik.
Ein Affinitätsmodell, das nach einer Fusion eingeführt wird, rechnet auf einem Bestand mit zwei Vergangenheiten. Die Datenqualität gehört dann getrennt nach Herkunftsbestand ausgewertet, denn ein Durchschnitt verdeckt genau den Teil, der das Problem hat.
Wie ein Institut den Zustand seines Bestands misst
Vor dem ersten Modelllauf reichen vier Kennzahlen: Dublettenquote im Personenbestand, Anteil verwaister Betreuerzuordnungen, Anteil der Kunden ohne aktuelles Berufsmerkmal und Anteil der Kunden ohne hinterlegten bevorzugten Kanal. Diese vier Werte lassen sich aus dem Bestand ziehen, ohne ein Projekt aufzusetzen.
Die Werte beantworten auch die Frage, die im Rollout oft zu spät gestellt wird: Für welchen Anteil des Bestands kann das Modell überhaupt einen belastbaren Impuls erzeugen? Daneben steht eine rechtliche Begrenzung, die Werbeeinwilligung im Bestand.
Was das Management vor dem Rollout klären sollte
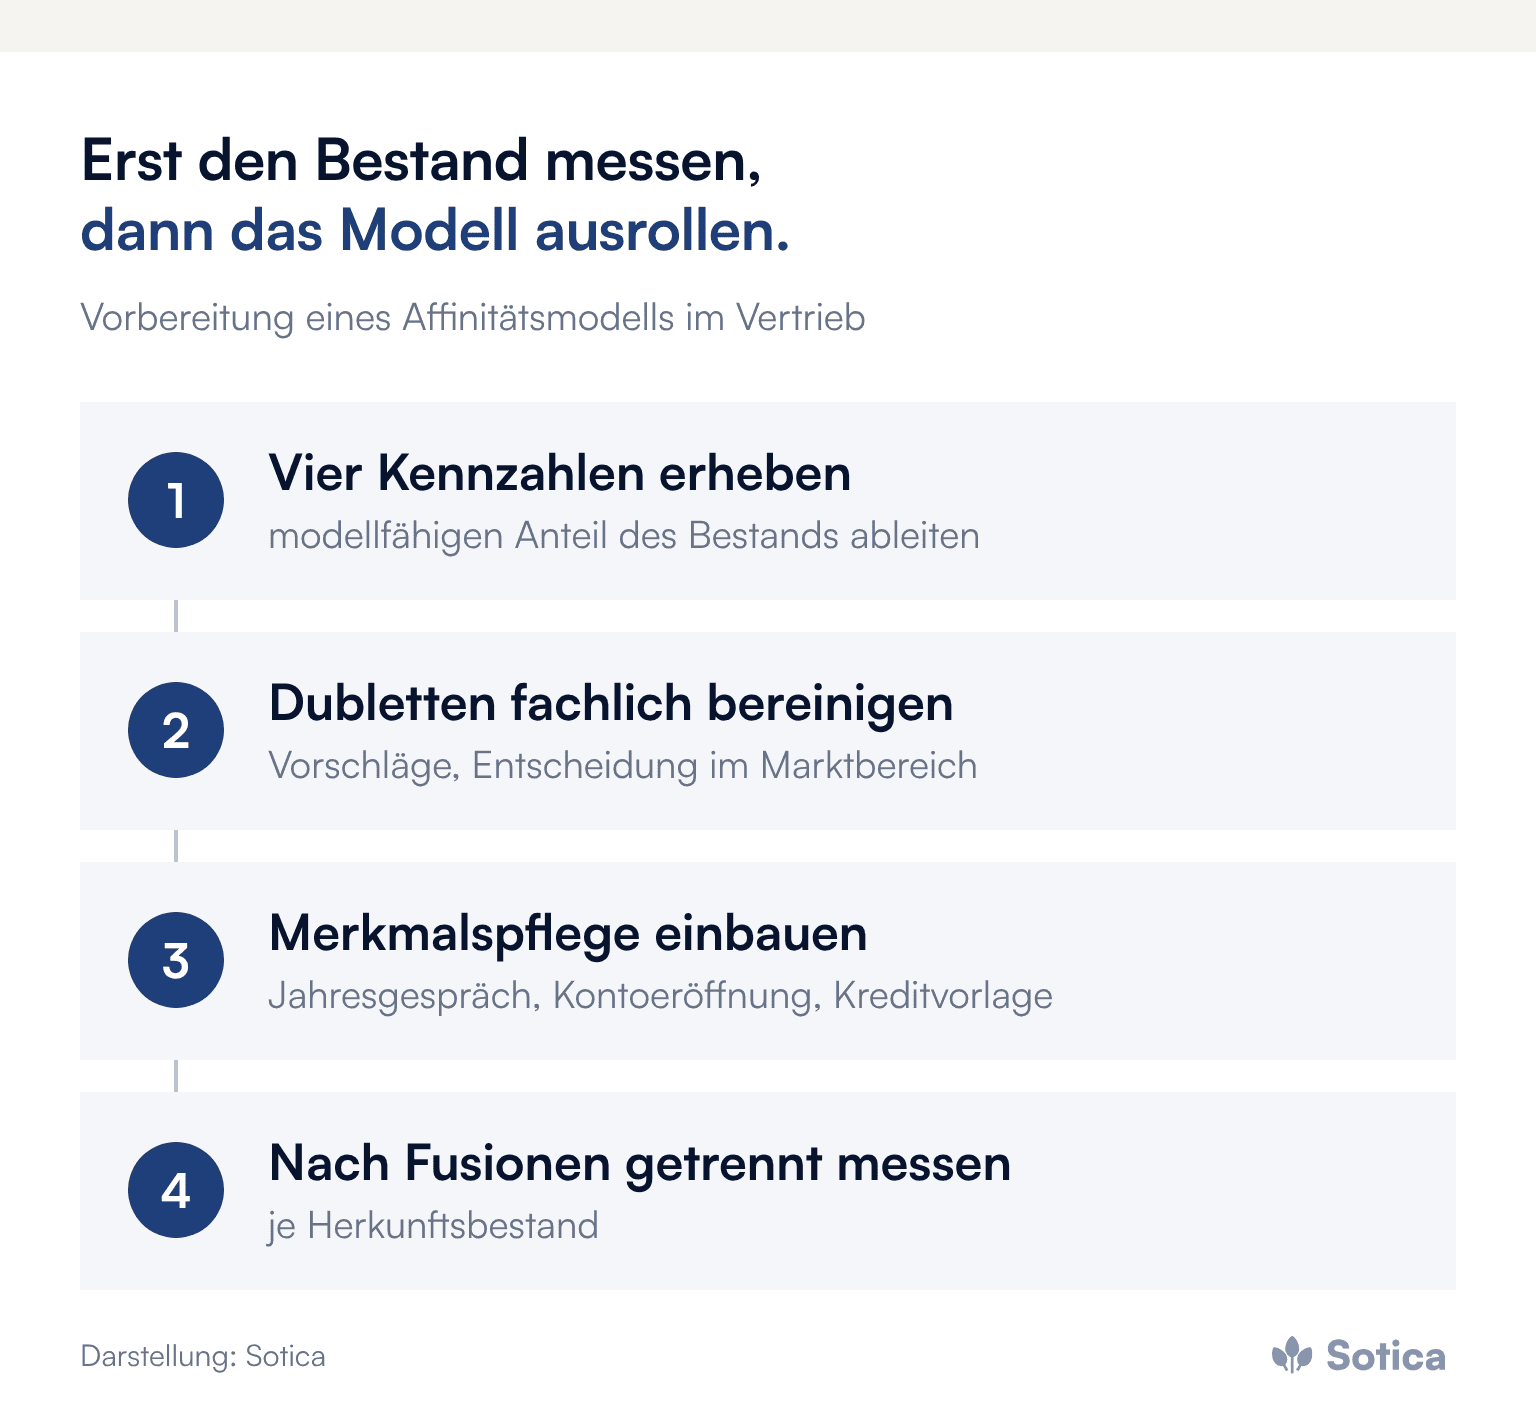
Die vier Kennzahlen erheben und daraus den modellfähigen Anteil des Bestands ableiten.
Die Dublettenbereinigung fachlich verankern: maschinelle Vorschläge, Entscheidung im Marktbereich, fester Abschlusstermin.
Merkmalspflege in den Beratungsprozess einbauen, gekoppelt an Jahresgespräch, Kontoeröffnung und Kreditvorlage.
Nach Fusionen getrennt messen, je Herkunftsbestand, bevor ein Modell auf dem gemeinsamen Bestand rechnet.
Häufige Fragen
Was ist ein Affinitätsmodell im Bankvertrieb?
Ein statistisches oder KI-gestütztes Verfahren, das aus Kunden- und Kontodaten ableitet, für welches Produkt ein Kunde mit hoher Wahrscheinlichkeit offen ist, und daraus Impulse für die Beratung erzeugt.
Warum liefern Affinitätsmodelle manchmal offensichtlich falsche Impulse?
Meist wegen der Datenbasis: Dubletten, veraltete Merkmale oder falsche Betreuerzuordnungen führen zu doppelten oder unpassenden Impulsen, auch wenn das Modell selbst gut ist.
Wer sollte Kundenmerkmale pflegen?
Der Vertrieb, und zwar dort, wo die Information entsteht: im Beratungsgespräch und bei ohnehin stattfindenden Anlässen wie Kontoeröffnung oder Kreditvorlage.
Weitere Beiträge zu Datenqualität, Kernsystemen und Datenarchitektur bündelt das Dossier Daten & Kernsysteme.
Ob ein Affinitätsmodell in der Fläche angenommen wird, entscheidet sich oft an den ersten falschen Impulsen, lange bevor jemand die Modellgüte prüft. Über ein erstes Gespräch zu diesem Thema freuen wir uns.
Dominik Winkel
Gründer und Managing Partner