Insight
Dunkelverarbeitung beginnt im Posteingang, nicht im Bestand
Die Dunkelverarbeitungsquote eines Versicherers entscheidet sich im Posteingang: Nur erkannte, angereicherte Vorgänge laufen ohne Eingriff durch.
Prozesse & Effizienz
6 min Lesezeit
Kernaussage
Automatisierung endet dort, wo der Eingang nicht erkennt, was ankommt. Wer den Posteingang nicht als eigene Steuergröße führt, optimiert Strecken, die der Vorgang nie erreicht.

Die wichtigsten Erkenntnisse
Nur erkannte Vorgänge laufen dunkel durch
Vier Kennzahlen machen den Posteingang steuerbar
Eine Strecke zuerst, dann skalieren
Alle optimieren die Verarbeitung. Kaum jemand den Eingang.
Viel Budget fließt in automatisierte Strecken für Antrag, Bestand und Schaden, und am Anfang sortiert trotzdem ein Mensch die Post. Die Dunkelverarbeitungsquote eines Versicherers wird im Posteingang entschieden: Nur Vorgänge, die beim Eingang korrekt erkannt, klassifiziert und mit Daten angereichert werden, laufen ohne manuellen Eingriff durch die Strecke dahinter.
Jeder Vertrag erzeugt über seine Laufzeit Dokumente: Anträge, Änderungen, Kündigungen, Schadenmeldungen, Arztberichte, Rechnungen, Maklerkorrespondenz. Was davon unstrukturiert oder falsch zugeordnet ins Unternehmen kommt, landet in der Sachbearbeitung, egal wie automatisiert die nachgelagerte Strecke ist. Dunkelverarbeitung bezeichnet dabei die vollständig maschinelle Bearbeitung eines Vorgangs ohne menschlichen Eingriff.
Warum scheitert die Dunkelverarbeitung so oft am Eingang?
Weil Vorgänge die automatisierte Strecke nie erreichen. Die Kernprozesse sind auf Dunkelverarbeitung ausgelegt, Regelwerke und Schnittstellen funktionieren, und trotzdem bleibt die Quote hinter den Erwartungen. Ein Kündigungsschreiben, das als allgemeine Korrespondenz klassifiziert wird, durchläuft keinen Kündigungsprozess. Eine Schadenmeldung ohne erkannte Vertragsnummer wartet auf einen Menschen, der sie zuordnet.
Die Kanalvielfalt verschärft das Problem. Post, E-Mail mit und ohne Anhang, Portale, Makleranbindungen über BiPRO, Apps und Fotos vom Smartphone liefern denselben fachlichen Vorgang in völlig unterschiedlicher Qualität. Ein Input-Management, das nur den klassischen Scan-Prozess beherrscht, verarbeitet ausgerechnet den wachsenden Teil der Eingänge am schlechtesten: formlose digitale Nachrichten.
Was leistet moderne Dokumentenerkennung heute?
Klassische Erkennungssoftware arbeitete mit Vorlagen und festen Auslesezonen und scheiterte an allem, was vom erwarteten Format abwich. Sprachmodelle klassifizieren heute auch formlose Schreiben zuverlässig, extrahieren Vertragsnummern, Namen und Anliegen aus Fließtext und erkennen, dass ein einziges Kundenschreiben drei Anliegen enthält: Adressänderung, Beitragsfrage und Kündigungsandrohung.
In der Versicherungswirtschaft ist diese Technik im Betrieb angekommen. In der Studie „Unter der Oberfläche: KI in der Versicherung“ von Sollers Consulting, für die Führungskräfte von 35 Versicherern in Europa und Nordamerika befragt wurden, ist die Datenextraktion mit 69 Prozent das häufigste Einsatzfeld von KI. Branchenübergreifend nutzen nach einer Umfrage des Digitalverbands Bitkom vom September 2025 36 Prozent der deutschen Unternehmen ab 20 Beschäftigten Künstliche Intelligenz, nach 20 Prozent im Vorjahr. Der Vorsprung entsteht damit nicht mehr durch den Zugang zur Technik, sondern durch die Qualität der Einbettung in den eigenen Prozess.
Was zeigen Beispiele aus der Praxis?
Mehrere produktive Lösungen dokumentiert das Whitepaper „Beyond the Pilot – Künstliche Intelligenz in der Versicherungswirtschaft“ des Bitkom aus dem Jahr 2026. Bei der Maklergruppe MRH Trowe dauerte die Verarbeitung eingehender Post früher bis zu drei Tage; mit einem KI-gestützten Posteingang erreicht ein Dokument das Kundenmanagementsystem nach rund 180 Sekunden. Die Erkennungsquote liegt laut Whitepaper bei etwa 95 Prozent, und ungefähr jedes zweite Dokument wird vollständig ohne manuellen Schritt verarbeitet. Allianz setzt nach demselben Whitepaper KI-Agenten unter anderem für die Klassifizierung eingehender Dokumente und die Datenextraktion aus Briefen ein.
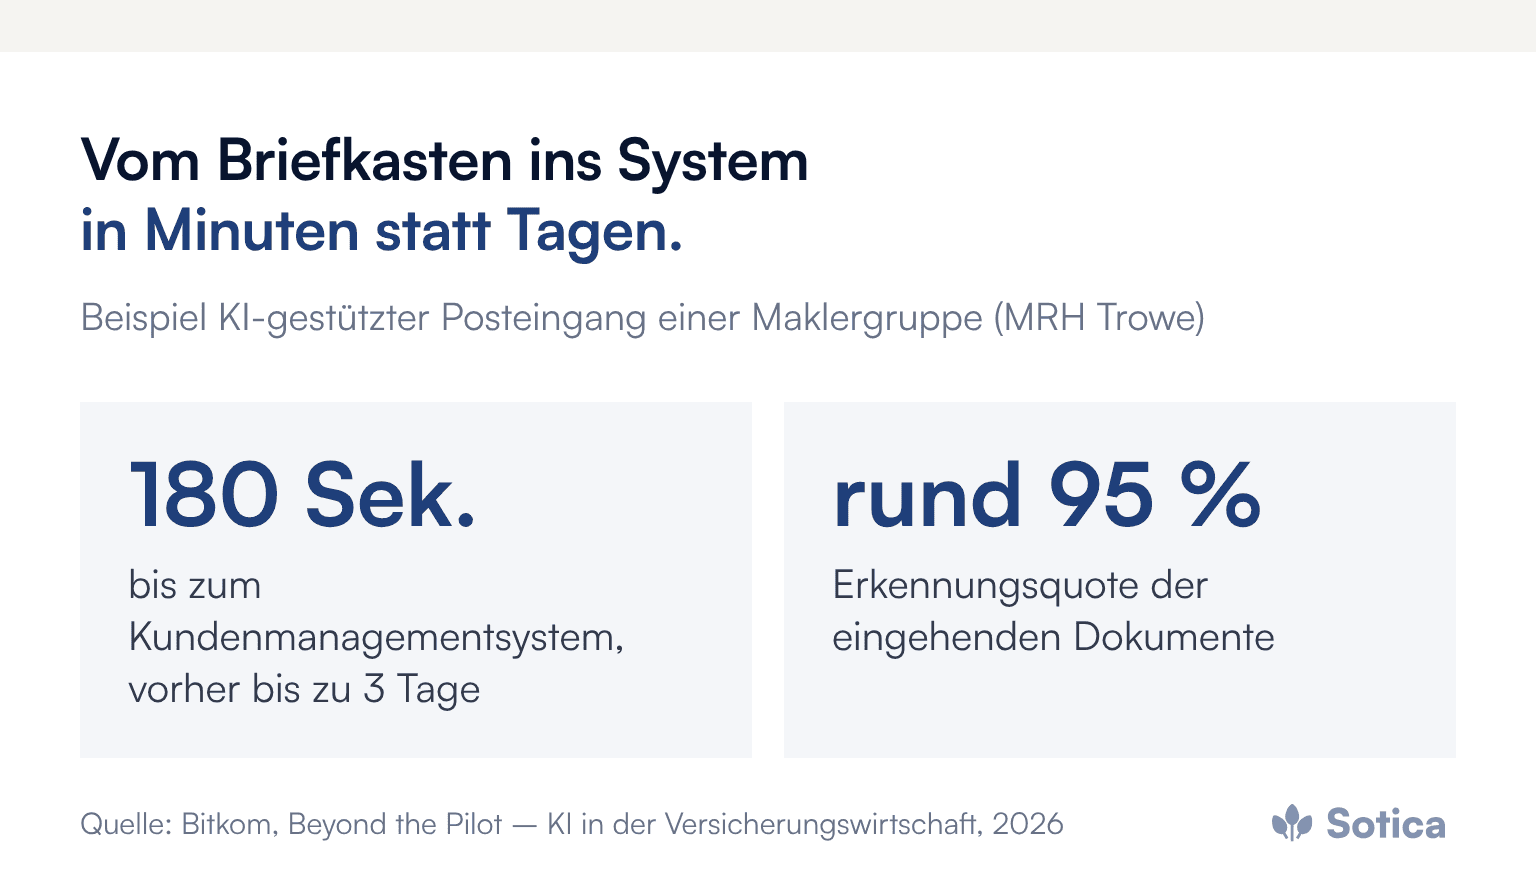
Bemerkenswert ist das Verhältnis der Zahlen: Eine hohe Erkennungsquote führt nicht automatisch zu einer ebenso hohen Durchleitung. Zwischen „richtig erkannt“ und „ohne Eingriff verarbeitet“ liegen die Anreicherung mit Bestandsdaten und die Übergabe an den Folgeprozess.
Wo liegt der häufigste Denkfehler?
In der Erkennung ohne Konsequenz. Viele Projekte verbessern die Klassifikation, lassen den nachgelagerten Prozess aber unverändert. Dann produziert das Input-Management sauber klassifizierte Vorgänge, die trotzdem in einer Sammelablage landen, weil kein Prozess sie automatisch entgegennimmt. Der Nutzen entsteht erst, wenn Klassifikation und Datenanreicherung direkt in die Folgeverarbeitung münden: Der erkannte Vorgang startet den passenden Prozess, mit den extrahierten Daten vorbefüllt.
Eingang und Strecke gehören deshalb zusammen. Wie weit sich Antrags- und Bestandsprozesse dunkel führen lassen, beschreibt die Analyse zur Dunkelverarbeitung in Antrag und Bestand. Der Posteingang ist das Ventil davor: Er bestimmt, wie viel überhaupt in diese Strecken einfließt, und wie lange Vorgänge zwischen Stationen liegen, wie der Beitrag zu Durchlaufzeit und Übergaben zeigt.
Welche Kennzahlen machen den Posteingang steuerbar?
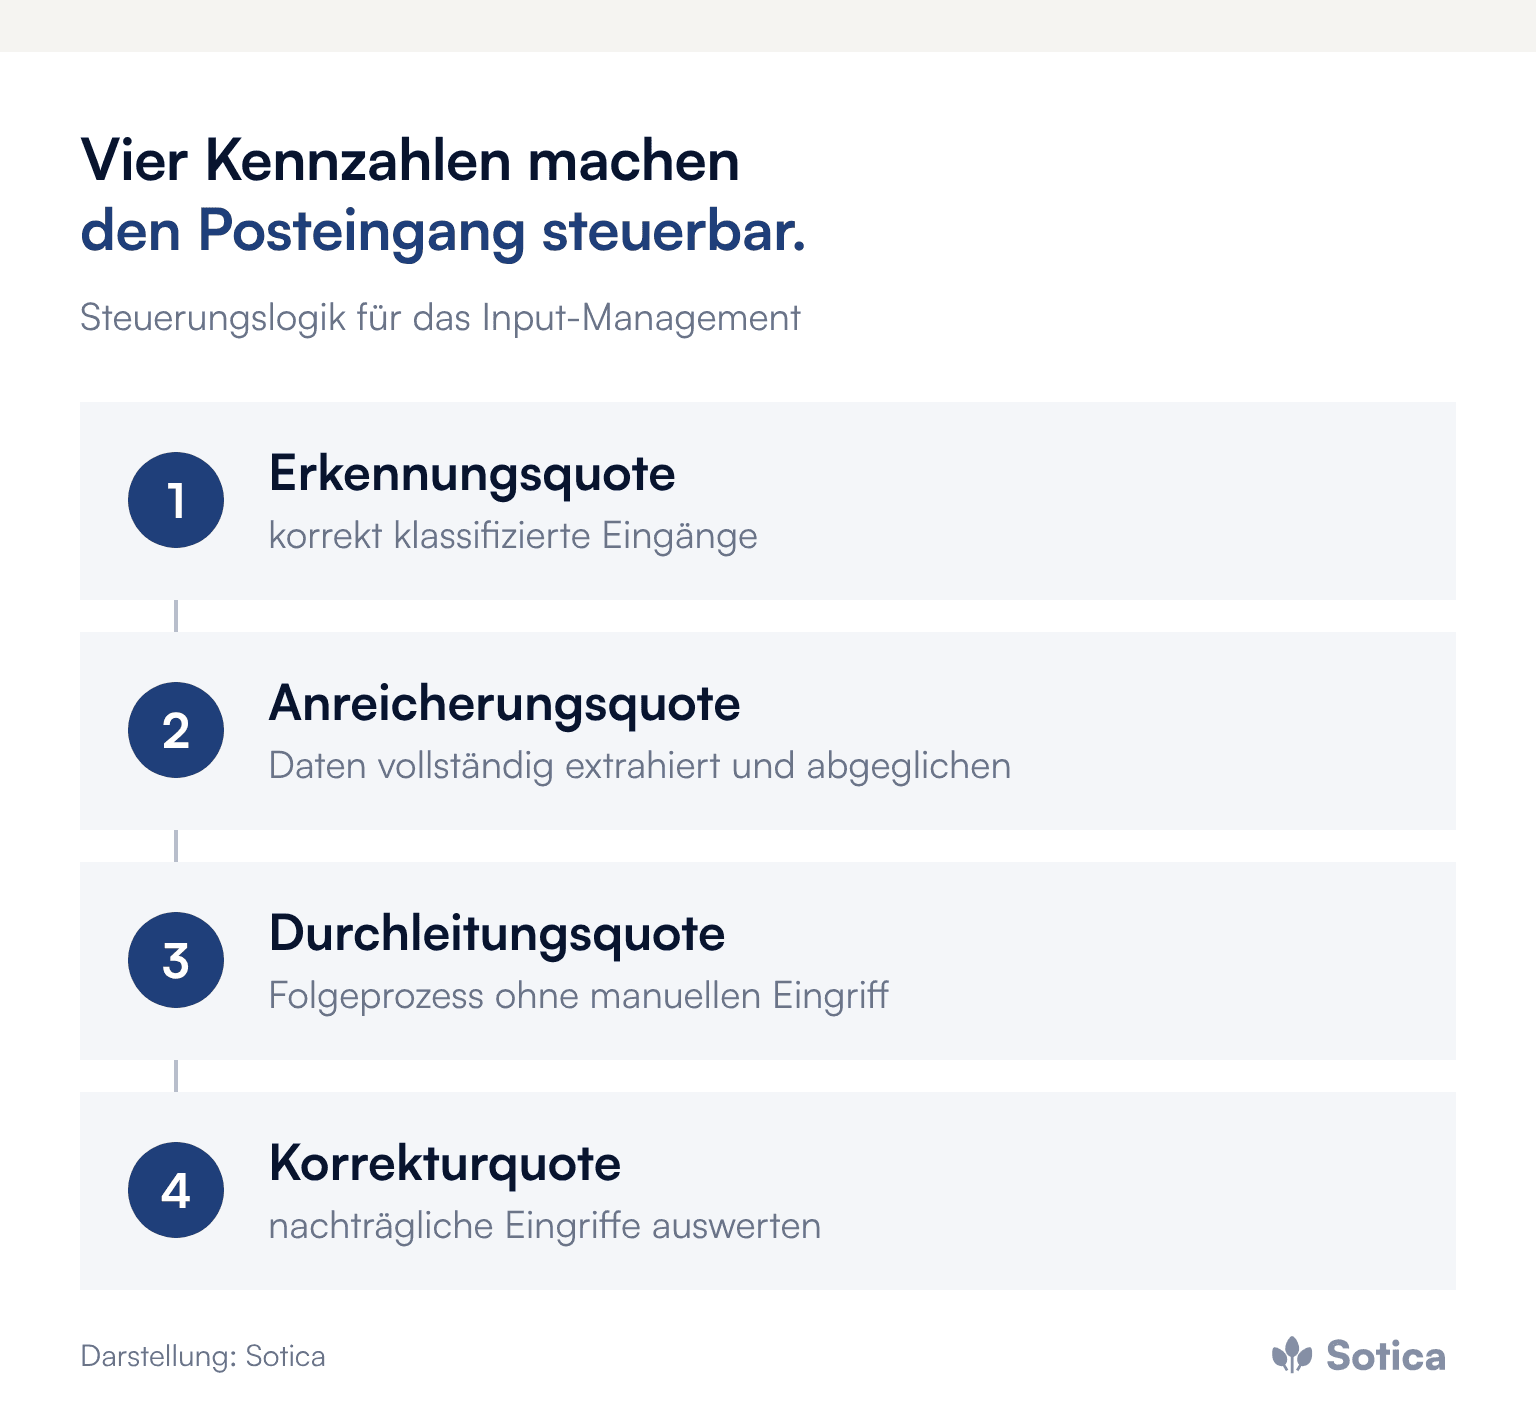
Vier Kennzahlen machen aus dem gefühlten Ärgernis eine steuerbare Größe:
Erkennungsquote: Welcher Anteil der Eingänge wird automatisch korrekt klassifiziert?
Anreicherungsquote: Bei welchem Anteil werden die fachlich nötigen Daten vollständig extrahiert und mit dem Bestand abgeglichen?
Durchleitungsquote: Welcher Anteil startet ohne manuellen Eingriff einen Folgeprozess?
Korrekturquote: Wie oft greifen Mitarbeitende nachträglich in automatisch verarbeitete Vorgänge ein?
Die vier Werte zeigen, wo der Engpass wirklich liegt. Häufig ist die Erkennung besser als ihr Ruf, und es hakt an der Übergabe in die Prozesse. Genauso oft gilt das Gegenteil. Ohne Messung entscheidet das Bauchgefühl, und das liegt erfahrungsgemäß häufiger daneben als die Zahlen.
Wie sieht ein pragmatischer Einstieg aus?
Mit einer Dokumentart und einem Prozess. Der falsche Weg ist das Großprojekt, das den gesamten Posteingang in einem Zug neu baut. Der richtige Einstieg ist eine Dokumentart mit hohem Volumen und klarem Folgeprozess: Kfz-Schadenmeldungen, Rechnungen in der Krankenversicherung, Adressänderungen oder Kündigungen. An dieser einen Strecke wird das Zusammenspiel aus Erkennung, Anreicherung und Prozessstart aufgebaut, gemessen und stabilisiert. Wie eine solche durchgängige Strecke aussieht, zeigt der Beitrag zum Intelligent Document Processing in der Antragsstrecke.
Erst wenn die erste Strecke läuft, folgt die zweite. Die Sachbearbeitung gehört von Anfang an an den Tisch, denn sie kennt die Sonderfälle, an denen jede Automatisierung hängt, und entscheidet mit ihrer Akzeptanz über den Erfolg. Auch Beschwerden sind ein guter Kandidat, weil ihre schnelle Erkennung unmittelbar wirkt, wie der Beitrag zum KI-gestützten Beschwerdemanagement zeigt.
Warum braucht der Posteingang eine feste Verantwortung?
Weil ein Input-Management nie fertig ist. Jede manuelle Korrektur ist ein Datenpunkt: Welche Dokumentart wurde falsch erkannt, welcher Absender liefert regelmäßig Problemfälle, welche Extraktion scheitert wiederholt? Unternehmen, die Korrekturen systematisch auswerten, verbessern ihre Quoten Monat für Monat. Unternehmen, die sie nur abarbeiten, korrigieren denselben Fehler jahrelang.
Organisatorisch braucht es ein Team, das die Eingangsquoten überwacht, Korrekturmuster analysiert und Erkennungsregeln nachzieht. Ohne diesen Regelkreis verfällt jede gute Anfangsquote, weil sich Dokumente, Absender und Kanäle laufend ändern. Hundert Prozent Dunkelverarbeitung sind dabei weder erreichbar noch wünschenswert: Komplexe und heikle Fälle landen zu Recht bei Menschen.
Vier Schritte für das Management
Den Posteingang als eigene Steuergröße führen, mit den vier Kennzahlen je Dokumentart.
Eine Startstrecke wählen mit hohem Volumen und klarem Folgeprozess.
Erkennung und Prozessstart gemeinsam bauen, damit erkannte Vorgänge nicht in einer Sammelablage enden.
Eine Verantwortung benennen, die Korrekturen auswertet und die Regeln laufend nachzieht.
Häufige Fragen
Was ist Input-Management?
Die Gesamtheit aller Schritte, mit denen eingehende Dokumente und Nachrichten erkannt, klassifiziert, mit Daten angereichert und an den richtigen Prozess übergeben werden, unabhängig vom Kanal.
Reicht eine hohe Erkennungsquote?
Nein. Entscheidend ist die Durchleitungsquote, also der Anteil der Vorgänge, die ohne Eingriff einen Folgeprozess starten.
Mit welcher Dokumentart sollte der Einstieg erfolgen?
Mit einer Dokumentart, die häufig vorkommt und einen klaren Folgeprozess hat, etwa Schadenmeldungen, Rechnungen oder Adressänderungen.
Weitere Beiträge zu Posteingang, Extraktion und Dunkelverarbeitung bündelt das Dossier Eingangs- & Dokumentenverarbeitung.
Welcher Anteil der eigenen Eingänge heute ohne Eingriff einen Folgeprozess startet, ist eine Zahl, die in vielen Unternehmen niemand kennt, obwohl sie über die Quote der gesamten Strecke entscheidet. Für ein erstes Gespräch zu diesem Thema sind wir gern da.

Dominik Winkel
Gründer & Managing Partner, Sotica. Partner für Wandel in der Finanzbranche. Von der Herausforderung bis zur Lösung im Tagesgeschäft.
Thema zurzeit im Fokus?
Im Gespräch ordnen wir Ausgangslage und Handlungsspielraum direkt ein. Unverbindlich und ohne Umwege.


